はじめに
『DApps開発入門』という本や色々記事を書いているかるでねです。
今回は、既存のPatriciaツリーを凍結して並行導入するVerkleツリーを使うことで、ステート証明のサイズを数キロバイトから数百バイトに削減し、ステートレスクライアントの効率的な同期を実現仕組みを提案しているEIP6800についてまとめていきます!
以下にまとめられているものを翻訳・要約・補足しながらまとめていきます。

他にも様々なEIPについてまとめています。

概要
EIP6800は、Ethereumのステートを管理する既存の「hexary Patricia tree」に加えて、新たに「Verkle tree」を導入する提案です。 ハードフォーク後は、従来のPatriciaツリーは読み取り専用となり、ステートの更新はすべてVerkleツリーへ記録されます。 さらに、トランザクション実行中にアクセスされたすべてのアカウントやストレージのコピーもVerkleツリーに保持されるため、将来的にはPatriciaツリーを廃止して完全にVerkleツリーで実行ステートを管理できるようになります。
hexary Patricia tree
hexary Patricia tree は、Ethereum の状態管理に用いられる木構造で、キーを16進数(hexary)の枝に沿って辿りつつ、経路圧縮(Patricia)を組み合わせることで状態データを効率的に格納します。 各ノードは最大で16本の子枝を持ち、データの保存や更新時にはハッシュ値を用いてノードの整合性を検証します。 経路圧縮により、連続する一意の経路部分は単一のエクステンションノードとしてまとめられ、ツリーの深さを抑制します。 これにより、空間効率と検索速度の両立が図られています。
Ethereum のブロックチェーンではアカウント情報やストレージデータをこの Patricia tree に格納し、ブロックヘッダーにはルートハッシュだけを保持します。 トランザクション実行時には、必要なアカウントやストレージに対応する Merkle proof(証明)を生成し、ノード間のハッシュ計算で正当性を検証します。
Verkle tree
Verkle treeは、Patricia treeの課題である証明サイズの肥大化を解消するために提案されたデータ構造で、Pedersenコミットメントを用いてノード間の結合を行います。 hexary Patricia tree では平均で数キロバイトに及ぶMerkle proofが、Verkle treeでは平均約200バイトにまで削減され、ネットワーク負荷が大幅に軽減されます。
Verkleツリーの各ノードでは、あらかじめ決められた「Pedersen(ペダーセン)基底ベクトル」と呼ぶたくさんのポイントと、それぞれに対応する数値(スカラー値)を使います。 具体的には、まず全体を表す無限遠点からスタートし、基底ベクトルの1つひとつに子ノードの数値を掛け合わせ、その結果を順に足し合わせていきます。 この一連の計算で得られるポイントが、そのノードの「コミットメント点」です。
キー(32バイト)のうち先頭31バイトを「ステム」、最後の1バイトを「サフィックス」と見なします。 あるステムに属する値を同じステム同士でまとめ、256通りあるサフィックスごとに小さなリーフ(葉)を並べた部分ツリーを作ります。 こうすることで、大きな全体ツリーを扱いやすい単位に分割できます。
葉に保存する数値が「本当に0を意味する場合」と「何も設定されていない空の位置」を区別するため、値の下半分(16バイト部分)にあらかじめ を加えます。 この工夫によって、後からツリーを読み取るときに「ここは0を保存したのか」、「そもそも値がないのか」が明確に区別できるようになります。
まず各ステムごとに部分ツリーをまとめて一つのスカラー値に変換し、そのあとステム全体をまたPedersenコミットメントで組み合わせます。 この処理を上から下まで再帰的に行うことで、最終的に1つの「ルートコミットメント点」が得られます。 このルートがEthereumの状態を一意に表し、Patriciaツリーに比べて証明サイズを数キロバイトから数百バイトにまで劇的に小さくできます。
動機
Ethereumのステートレスクライアント対応を妨げている大きな要因は「証明データ(witness)のサイズ」です。 現在のPatriciaツリーでは、あるアカウントに対するMerkle証明を生成すると平均で約3 kB、最悪の場合はその三倍にも達します。 Ethereumブロック内で最大約6,000回のアカウントアクセスが発生すると仮定した場合、一ブロックあたりの証明サイズは最大で約18 MBに膨れ上がり、これを12秒のブロックタイム内にピアツーピアネットワークで安全に送信することは現実的ではありません。
一方でVerkleツリーは、アカウントごとの証明サイズを平均約200 Bにまで削減できる性質があります。 この大幅なサイズ削減により、ステートレスクライアントが必要とする証明データをネットワーク上で効率的かつ安全にやり取りできるようになり、Ethereumネットワークのスケーラビリティと分散性をさらに向上させることが可能になります。
仕様
Verkleツリー
Verkleツリーは、固定長のキー(32バイト)と値(32バイト)の組みをもとに、階層的にコミットメントを積み重ねて状態を表現するデータ構造です。 ノード同士の連携部分にMerkleツリーではなくPedersenコミットメントを用いることで、Proof(証明)サイズを大幅に小さくできます。
# Bandersnatch curve order
BANDERSNATCH_MODULUS = \
13108968793781547619861935127046491459309155893440570251786403306729687672801
# Bandersnatch Pedersen basis of length 256
PEDERSEN_BASIS = [....]
VERKLE_NODE_WIDTH = len(PEDERSEN_BASIS)

def group_to_scalar_field(point: Point) -> int:
    # Not collision resistant. Not random oracle.
    # Binding for Pedersen commitments.
    assert isinstance(point, Point)
    if point == bandersnatch.Z:
        return 0
    else:
        return point.map_to_base_field() % BANDERSNATCH_MODULUS

def compute_commitment_root(children: Sequence[int]) -> Point:
    o = bandersnatch.Z
    for generator, child in zip(PEDERSEN_BASIS, children):
        o = bandersnatch.add(o, bandersnatch.mul(generator, child))
    return o

def extension_and_suffix_tree(stem: bytes31, values: Dict[byte, bytes32]) -> int:
    sub_leaves = [0] * 512
    for suffix, value in values.items():
        sub_leaves[2 * suffix] = int.from_bytes(value[:16], 'little') + 2**128
        sub_leaves[2 * suffix + 1] = int.from_bytes(value[16:], 'little')
    C1 = compute_commitment_root(sub_leaves[:256])
    C2 = compute_commitment_root(sub_leaves[256:])
    return compute_commitment_root([1, # Extension marker
                                    int.from_bytes(stem, "little"),
                                    group_to_scalar_field(C1),
                                    group_to_scalar_field(C2)] +
                                    [0] * 252)

def compute_main_tree_root(data: Dict[bytes32, int],
                           prefix: bytes) -> int:
    # Empty subtree: 0
    if len(data) == 0:
        return 0
    elif len(data) == 1:
        return list(data.values())[0]
    else:
        sub_commitments = [
            compute_main_tree_root({
                    key: value for key, value in data.items() if
                    key[:len(prefix) + 1] == prefix + bytes([i])
                }, prefix + bytes([i]))
            for i in range(VERKLE_NODE_WIDTH)
        ]
        return group_to_scalar_field(compute_commitment_root(sub_commitments))

def compute_verkle_root(data: Dict[bytes32, bytes32]) -> Point:
    stems = set(key[:-1] for key in data.keys())
    data_as_stems = {}
    for stem in stems:
        commitment_data = Dict[byte, bytes32]()
        for i in range(VERKLE_NODE_WIDTH):
            if stem + bytes([i]) in data:
                commitment_data[i] = data[stem + bytes([i])]
        data_as_stems[stem] = extension_and_suffix_tree(stem, commitment_data)
    sub_commitments = [
        compute_main_tree_root({
                key: value for key, value in data.items() if
                key[0] == i
            }, bytes([i]))
        for i in range(VERKLE_NODE_WIDTH)
    ]
return compute_commitment_root(sub_commitments)ノードコミットメントの計算
各ノードにはあらかじめ定義されたPedersen基底(長さがノード幅)と、対応する子ノードのスカラー値列が対応づけられています。
compute_commitment_root関数では、まず出発点として無限遠点(ゼロ点)を取り、基底とスカラー値を一対ずつ乗算して加算していくことで、そのノード全体のコミットメント点を得ます。
拡張ツリーとサフィックスツリーの構築
葉ノードの部分では、キーの末尾バイトを「サフィックス」として扱い、同じステム(キーの上位31バイト)に属する値を集めて256本のサブリーフに配置します。 値が存在する場合は下位16バイトと上位16バイトに分けてそれぞれ整数化し、下位側には常に を加えることで「ゼロ値」と「空位置」の区別も担保します。 その後、前半256個と後半256個でそれぞれコミットメントを計算し、ステム情報と拡張マーカーを合わせて再度コミットメントを行い、該当ステムのサブツリーを一つのスカラー値としてまとめます。
メインツリーのルート計算
全てのステムを集めた後、メインツリーではキーの先頭バイト(プレフィクス)ごとに再帰的に部分集合を抽出し、空の場合は0を、要素が1つならそのまま値を、複数ならPedersenコミットメントを用いてまとめたスカラー値を返します。 この処理をノード幅分(通常は256回)行い、得られた子コミットメント列を再度コミットすることで最上位のコミットメント点を算出します。
完全なVerkleルートの算出
最終的には、すべてのサブコミットメント点を compute_commitment_root に渡し、Pedersen基底との組み合わせから1つのルートコミットメント点(Point型)を得ます。
この値がVerkleツリー全体の状態を一意に表現し、後続の検証や同期の基準となります。
ゼロ値と空位置の区別
既存のPatriciaツリーにはない仕様として、Verkleツリーでは「値がゼロであること」と「位置に値が設定されていないこと」を明確に区別します。 葉レイヤーでサブリーフを構築する際に下位部分に を加えるのは、空のサブリーフ(何もない状態)と実際にゼロを保存したい場合とを判別するためです。 この工夫により、後続の検証アルゴリズムが正しく動作します。
イラスト
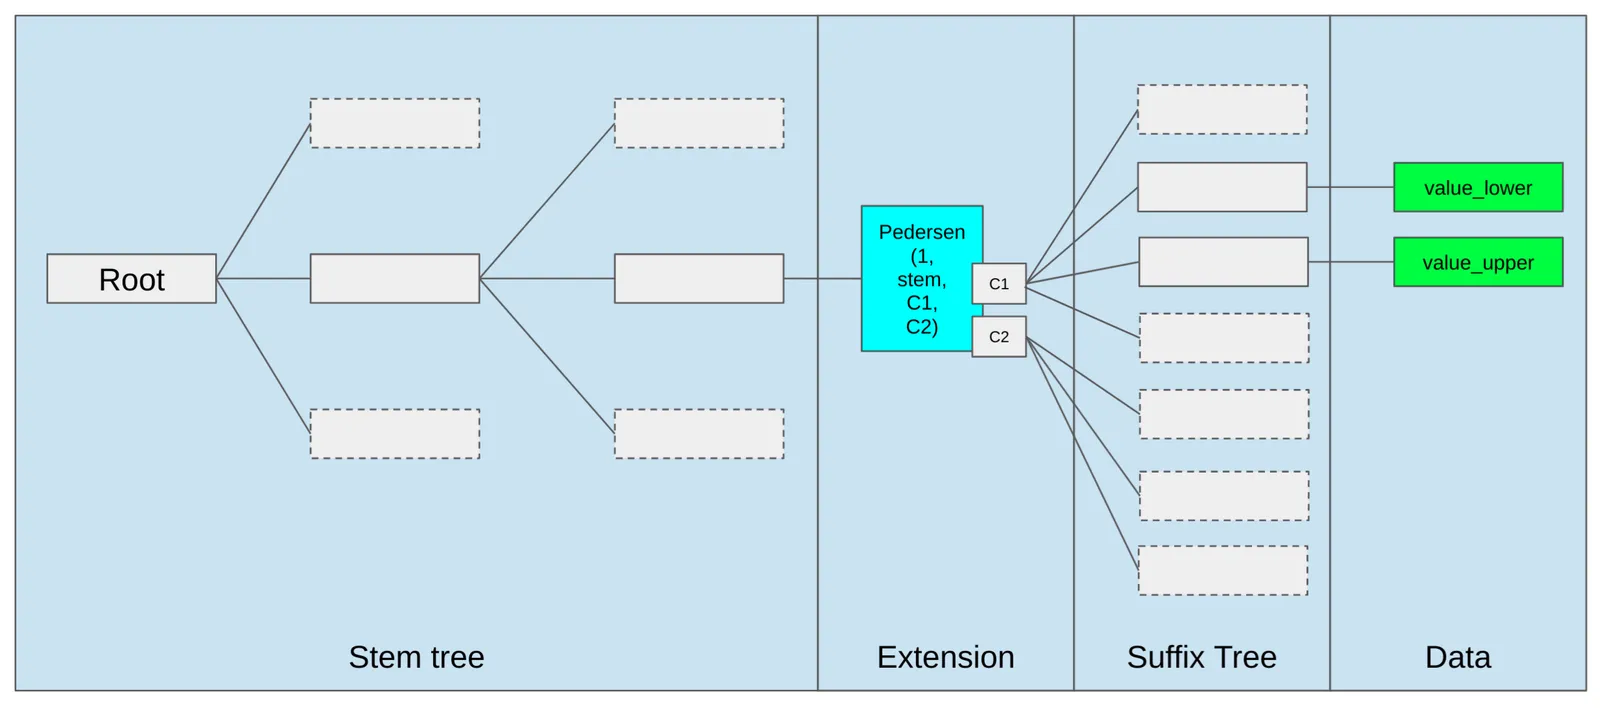
ツリーへの埋め込み
VerkleツリーではPatriciaツリーのように複数層に分かれた構造ではなく、全ての情報を一つのキー:値のツリーにまとめて格納します。 アカウントの基本データ、コードハッシュ、ストレージ、コード本体など、それぞれをどのキー位置に置くかを以下のパラメータで定義します。
| パラメータ | 値 |
|---|---|
BASIC_DATA_LEAF_KEY |
|
CODE_HASH_LEAF_KEY |
|
HEADER_STORAGE_OFFSET |
|
CODE_OFFSET |
|
VERKLE_NODE_WIDTH |
|
MAIN_STORAGE_OFFSET |
これらの値は必ず VERKLE_NODE_WIDTH > CODE_OFFSET > HEADER_STORAGE_OFFSET を満たし、HEADER_STORAGE_OFFSET はリーフキー(0 と 1)より大きくなければなりません。
また MAIN_STORAGE_OFFSET は VERKLE_NODE_WIDTH の冪(べき)である必要があります。
アドレス形式の統一
既存の20バイトアドレスを Verkle ツリーのキーに使う時は、先頭に12バイトのゼロを付けて32バイトに拡張します。
def old_style_address_to_address32(address: Address) -> Address32:
return b'\x00' * 12 + addressヘッダー情報の格納位置
アカウントのバージョン、コードサイズ、ナンス、残高といったヘッダー情報は、BASIC_DATA_LEAF_KEY(値0)に対応する位置の値の中に、バイトオフセットとサイズを決めてパックして保存します。
オフセットはバージョンが0、コードサイズが5~7バイト、ナンスが8~15バイト、残高が16~31バイトに割り当てられており、バージョン設定時にヘッダー全体が再書き込みされます。
コードハッシュは CODE_HASH_LEAF_KEY(値1)で同様に扱われます。
コードの格納とチャンク化
コントラクトのバイトコードは CODE_OFFSET から始まる位置に、31バイトずつ切り分けて保存します。
各チャンクには、先頭バイトに「このチャンクの最初がPUSHDATAの何バイト目か」を示す値を置き、続く31バイトに実際のコード断片を格納します。
def chunkify_code(code: bytes) -> Sequence[bytes32]:
    # 31バイト境界でパディングと分割を行い、PUSHDATA位置を計算して先頭バイトに設定
…こうして得られたチャンクは、チャンクごとに get_tree_key_for_code_chunk で対応するツリーキーにマッピングされます。
ストレージの格納位置
スマートコントラクトのストレージスロットは、オフセットが HEADER_STORAGE_OFFSET 未満の範囲ならそのまま加算して配置し、それ以外は MAIN_STORAGE_OFFSET をベースに加算して配置します。
同一ノード幅内の関連スロットはひとまとめにコミットメントされるため、一度に近接した複数のスロットを扱う際に証明データを効率化できます。
フォークとアクセスイベント
この仕様はEIP7612のハードフォークで導入され、既存のPatriciaツリーは読み取り専用になります。 トランザクション実行時のアクセスログはEIP4762によって定義されたアクセスイベントとして記録され、Verkleツリー上での読み書きが追跡可能になります。
補足
EIP6800では、既存のPatriciaツリーを一度凍結し、新たに空のVerkleツリーを並列して導入します。 トランザクション実行による状態変更や参照された状態のコピーはすべてVerkleツリーに記録され、Patriciaツリーは読み取り専用のまま残ります。 こうすることで、ツリー構造を一度に全面的に置き換えるのではなく、段階的に移行できる環境を整えています。 将来的なハードフォーク時には、固定化されたPatriciaツリーの内容をオフチェーンでVerkleツリーに移し替えるだけで済み、クライアント側でリアルタイムに巨大なツリー変換を行う必要がなくなります。
Verkleツリー設計のポイント
Verkleツリーは単層のキー/値ストアとして構成され、32バイトのキーと値を直接扱います。 これにより、データベース操作やキャッシュ、同期、証明生成・検証のコードがシンプルになり、将来的に別のツリー構造へアップグレードしやすくなります。 また、状態がツリー全体に均一に散らばるため、一部のストレージに極端にデータが集中する攻撃に対して強く、ステート同期の効率も向上します。 アカウントヘッダーやコードも同じ構造内に格納するため、新機能の追加や拡張が容易になる設計です。
ガスコストの改定
Verkleツリーへの移行に合わせて、コードやストレージの読み書きにかかるガスコストを見直します。 コードチャンク(31バイト単位)へのアクセスは1バイトあたり約6.25ガス、枝ノード(証明の分岐部分)は平均144バイト想定で約13.2ガス/バイトとし、最悪ケースでも約2.5ガス/バイトになるよう設定します。 Berlinアップデート以降と比べると、コードチャンクアクセス時に1チャンクあたり200ガスが追加され、平均で6~12%のガス増が見込まれます。 一方で同一ノード幅内の隣接ストレージスロットアクセスは初回2100ガスから200ガスに大幅軽減され、特にオフセット0~63のスロットはすべて200ガスに統一されるため、多くの既存コントラクトのパフォーマンスが向上すると期待されます。
互換性
主な後方互換性への影響は二点あります。 1つ目は、コードチャンクアクセスのガス増加により、一部のアプリケーションが経済的に成り立たなくなる可能性があります。 これに対しては、EIP実装時にブロックガスリミットを引き上げることでトランザクションがブロック内で実行不能になるリスクを軽減できます。 2つ目は、ツリー構造が変わることで、EVM内部での過去状態証明(オンチェーンMerkle proof)が従来どおり動作しなくなります。 ただし、この点もPatriciaツリー凍結後にオフチェーンでの証明生成に切り替えれば対応可能です。
引用
Vitalik Buterin (@vbuterin), Dankrad Feist (@dankrad), Kevaundray Wedderburn (@kevaundray), Guillaume Ballet (@gballet), Piper Merriam (@pipermerriam), Gottfried Herold (@GottfriedHerold), Ignacio Hagopian (@jsign), Tanishq Jasoria (@tanishqjasoria), Gajinder Singh (@g11tech), Danno Ferrin (@shemnon), "EIP-6800: Ethereum state using a unified verkle tree [DRAFT]," Ethereum Improvement Proposals, no. 6800, March 2023. [Online serial]. Available: https://eips.ethereum.org/EIPS/eip-6800.
最後に
今回は「既存のPatriciaツリーを凍結して並行導入するVerkleツリーを使うことで、ステート証明のサイズを数キロバイトから数百バイトに削減し、ステートレスクライアントの効率的な同期を実現仕組みを提案しているEIP6800」についてまとめてきました! いかがだったでしょうか?
質問などがある方は以下のTwitterのDMなどからお気軽に質問してください!
他の媒体でも情報発信しているのでぜひ他も見ていってください!
