はじめに
初めまして。 『DApps開発入門』という本や色々記事を書いているAva Labsのかるでねです。
以下でも情報発信しているので、興味ある記事があればぜひ読んでみてください!


今回はAvalancheのコンセンサスメカニズムについてまとめていきます。 1つずつ順番に説明をしていくため、少し長いですが理解しやすくなっています。
概要
Avalancheコンセンサスは、ブロックチェーンの合意形成における課題を解決するために設計された、スケーラブルで堅牢な分散型プロトコルです。 その設計は、従来の主要な2つのコンセンサス方式である「クラシカルコンセンサス」と「ナカモトコンセンサス」の長所を融合させています。これにより、高速なトランザクションのファイナリティ、高いスループット、そしてプルーフ・オブ・ワーク(PoW)を不要とすることによる極めて低いエネルギー消費を実現しています。
クラシカルコンセンサス (PBFTなど)
高速かつ確定的なファイナリティを持つことが特徴です。 しかし、合意を形成するために参加者全員が相互に通信する必要があるため、参加者数が増えるにつれて通信量が爆発的に増加してスケーラビリティに大きな課題を抱えています。 主に、参加者が限定されたパーミッション型のネットワークで利用されます。
ナカモトコンセンサス (ビットコインなど)
プルーフ・オブ・ワーク(PoW)を用いることで、不特定多数が自由に参加できるパーミッションレスなネットワークを実現しました。 しかし、合意が確率的にしか保証されないため、トランザクションのファイナリティを得るまでに長い時間(数ブロックの承認)を要します。 また、PoWに伴う膨大なエネルギー消費も大きな課題です。 PoWに関しては以下の記事を参考にしてください。
仕組み
Avalancheコンセンサスのコアとなるのは、ネットワークに参加する各ノード(バリデーター)が、ランダムに抽出した少数のノード群(サブサンプル)に繰り返し意見を求めることで、ネットワーク全体の合意を形成するという独自のプロセスです。
具体的なプロセスは以下です。
- サンプリングと問い合わせ
あるトランザクションを検証したいノードは、ネットワークから少数のバリデーターをランダムにサンプリングし、そのトランザクションを支持するかどうかを問い合わせます。
ホワイトペーパーでは、この問い合わせの通信を「Query」と呼んでいます。
- 支持の更新 問い合わせの結果、一定数以上()のバリデーターから同じ回答が得られた場合、ノードは自身が支持する対象を、その多数派の意見に更新します。
- 連続成功カウンタの蓄積
この「サンプリングと支持の更新」プロセスを繰り返し実行します。
同じ対象への支持が多数派として連続で確認されると、その対象に対する連続成功カウンタ(
consecutiveSuccesses)が増加します。 異なる対象が多数派になった場合や、多数派が形成されなかった場合は、カウンタはリセットされます。 - 承認とファイナリティ 連続成功カウンタが事前に定められたしきい値()に達した時点で、そのトランザクションは最終的に「承認(Accept)」され、ファイナリティを得ます。
主な特徴とメリット
- 高速なファイナリティ トランザクションは1〜2秒という短い時間でファイナリティに達します。 これにより、決済などのアプリケーションで即時性が求められるユースケースに対応可能です。
- 高いスループット 合意形成に参加者全員の通信を必要とせず、サブサンプリングによってメッセージのオーバーヘッドを一定に保つため、ネットワークは毎秒数千件のトランザクションを処理する能力を持ちます。
- PoW不要による高いエネルギー効率 プルーフ・オブ・ワーク(PoW)のような膨大な計算リソースを消費しません。 また、処理すべきトランザクションがない場合、プロトコルは静止状態(Quiescent)となり、不要なエネルギー消費を大幅に抑制します。
- リーダーレスによる分散性と堅牢性 合意形成プロセスに特定の「リーダー」が存在しないため、単一障害点がなく、ネットワークの分散性と耐障害性が向上します。
- 柔軟なパラメータ設定 サンプリングにおいて多数派を判断するためのしきい値()や、承認までに必要な連続成功回数()といったパラメータは、ネットワークが求めるセキュリティレベルに応じて調整可能です。
Avalancheコンセンサスは、このアプローチにより、既存のブロックチェーンが直面していたスケーラビリティの問題を克服し、DeFi(分散型金融)からエンタープライズ領域まで、幅広いアプリケーションを支える基盤技術として期待されています。
全体像
Avalancheコンセンサスは、Snowと呼ばれるプロトコルファミリーを基盤としています。 これは、サブサンプリングによる繰り返し投票という単一のコアメカニズムを、段階的に改良・応用していく一連のプロトコルの集合体です。 その進化は、「単一の決定をどう行うか」という基礎プロトコルの確立から、「それをブロックチェーンにどう応用するか」、そして「どう最適化するか」という流れで理解することができます。
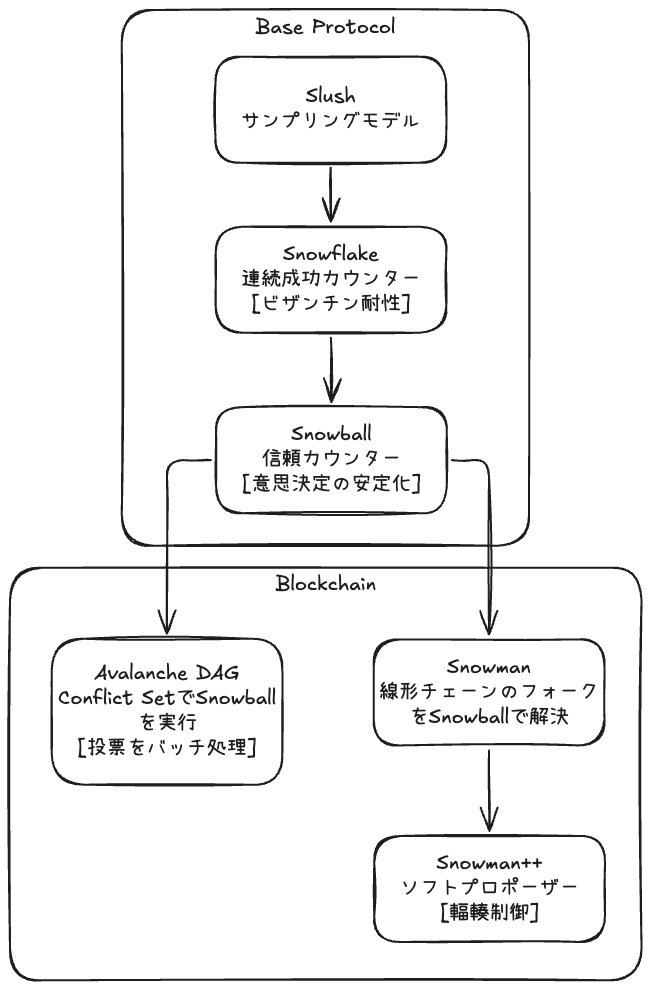
基礎プロトコルの進化(Slush → Snowflake → Snowball)
この段階では、対立する選択肢の中からネットワークとして1つだけを安全に選択する方法を確立します。
- Slush
- 役割 サブサンプリングのコア機能を示す最も単純なモデル。
- メカニズム 少数のノードに繰り返しクエリを行い、多数派の意見に自身の支持を合わせる。
- 限界 過去の投票履歴を記憶しないため、ビザンチン耐性を持たない。
- Snowflake
- 役割 Slushにビザンチン耐性を導入する。
- 導入機能
連続成功カウンターを追加。
同じ選択肢への支持が連続して多数派となった回数を記録し、一定回数(
β)に達するとその選択肢を承認する。 - 限界 支持対象が変わるとカウンターがリセットされるため、意見が拮抗する状況では決定が遅れる可能性がある。
- Snowball
- 役割 Snowflakeをさらに堅牢化し、より安定した意思決定を実現する。
- 導入機能
永続的な信頼カウンター(
preferenceStrength)を追加。 各選択肢が受けた総支持を蓄積し、最も信頼度の高いものを現在の支持対象(preference)とする。 最終決定はSnowflakeと同様の連続成功カウンターで行う。 - 完成形 これにより、単一のコンフリクト(対立)を解決するための、堅牢で効率的なプロトコルが完成する。
ブロックチェーンへの応用(Avalanche (DAG) と Snowman)
次に、完成したSnowballプロトコルを実際のブロックチェーン構造に適用します。
- Avalanche (DAG)
- 役割 SnowballをDAG(有向非巡回グラフ)構造に適用する。
- コンフリクトの対象 Conflict Set(例:同じUTXOを使う二重支払いトランザクション群)。 各Conflict Setごとに独立したSnowballインスタンスが実行される。
- 特徴 投票のバッチ処理。 1つの頂点への投票が、その全ての祖先頂点への投票としても扱われるため、多数のコンフリクトを一度のクエリで効率的に処理できる。
- Snowman
- 役割 Snowballを線形チェーン(トランザクションの完全な順序付けが必要な場合)に適用する。 C-ChainやP-Chainで利用される。
- コンフリクトの対象 ブロックチェーンのフォーク(同じ親ブロックを持つ複数の子ブロック)。 各フォークポイントでSnowballインスタンスが実行され、承認すべきチェーンを1つだけ選択する。
パフォーマンスの最適化(Snowman++)
最後に、Snowmanが稼働するチェーンで発生する実用上の問題を解決し、パフォーマンスを向上させます。
- Snowman++
- 役割 Snowmanにおける輻輳(ふくそう)制御を行う。
- 問題点 Snowmanでは誰でもブロックを提案できるため、ネットワークが混雑すると不要なフォークが多発し、ファイナリティまでの時間が長くなる。
- 導入機能 ソフトプロポーザーメカニズム。 各ブロック高に対して、ブロックを提案できるバリデーター(プロポーザー)を事前に少数だけ決定論的に選出する。 プロポーザーは指定されたタイムウィンドウ内でのみブロックを提案する。 これによりコンフリクトの発生を大幅に抑制する。ライブネスを保証するため、指定されたプロポーザーがブロックを生成しなかった場合は、最終的にどのバリデーターでも提案が可能になる。
まとめ
| プロトコル | 主な役割 / 導入されたコア機能 | コンフリクトの対象 |
|---|---|---|
| Slush | サブサンプリングの基本モデル | 2つの色(抽象的な選択肢) |
| Snowflake | 連続成功カウンターの導入によるビザンチン耐性の獲得 | 2つの色(抽象的な選択肢) |
| Snowball | 信頼カウンターの導入による意思決定の安定化 | 複数の色(抽象的な選択肢) |
| Avalanche | SnowballをDAGに応用、投票のバッチ処理 | Conflict Set(トランザクション群) |
| Snowman | Snowballを線形チェーンに応用 | ブロックのフォーク |
| Snowman++ | Snowmanにソフトプロポーザーを追加し、輻輳を制御 | ブロックのフォーク |
Snow
Avalancheコンセンサスは、「Snow」と総称されるプロトコルファミリーに基づいています。 Snowは単一のアルゴリズムではなく、Slush、Snowflake、Snowballという段階的に改良された一連のプロトコルの集合体です。
メタスタビリティとサブサンプリング
Snowプロトコルは、「メタスタビリティ(Metastability)」という概念と、それを実現するための「サブサンプリングによる繰り返し投票(Repeated Sub-sampled Voting)」というメカニズムに基づいています。
メタスタビリティ(Metastability)
コンセンサスプロセスは、以下の2つの状態で説明されます。
- メタステーブル状態 (Metastable State) ネットワークの意見が、対立する複数のトランザクションの間で均衡しており、まだ最終的な合意に至っていない不確定な状態。
- 安定状態 (Stable State) ネットワークが、対立するトランザクションのうちの1つを承認することで合意に達し、その決定が確率的に覆ることが極めて困難になった状態。
Snowの目的は、ネットワークをこのメタステーブル状態から安定状態へ効率的に遷移させることです。
サブサンプリングによる繰り返し投票
この状態遷移を実現するために、Snowはネットワーク全体ではなく、ごく少数のノード群(サブサンプル)に繰り返しクエリを行う手法を採用します。 各ノードは、ランダムに選んだ少数のノードに意見を求め、その結果(多数派の意見)に基づいて自身の支持するトランザクションを更新します。 このプロセスを繰り返すことで、ある意見へのわずかな偏りが正のフィードバックループによって増幅され、ネットワーク全体が急速に1つの状態(安定状態)へと収束していきます。
コアコンポーネントとパラメータ
Conflict Sets
Snowが実際に意思決定を行う対象は、個々のトランザクションではなく「Conflict Set」です。 これは、相互に排他的な(同時には成立し得ない)トランザクションの集合を指します。 最も典型的な例は、同じUTXOを消費しようとする2つのトランザクション(二重支払い)です。 この2つのトランザクションは1つのConflict Setを形成し、コンセンサスプロセスはこの集合の中から1つだけを承認することを目指します。
ステーク量による重み付けサンプリング
クエリ対象のk個のノードを選ぶ時、完全にランダムに選ぶわけではありません。
各ノードがステークしているAVAXの量に比例した確率でサンプリングされます。
これは、悪意のある攻撃者が大量のノード(ID)を安価に生成してネットワークの意思決定に不当な影響を与えるシビル攻撃(Sybil Attack)への耐性のためです。
ステーク量という経済的なコストと意思決定における影響力を結びつけています。
主要パラメータとトレードオフ
Snowの挙動は主に3つのパラメータによって制御され、これらは安全性(Safety: 矛盾したトランザクションが同時に承認されることがない性質)とライブネス(Liveness: プロセスが停止せず、トランザクションがいずれ必ず承認または拒否される性質)のトレードオフに直接影響します。
k(Sample Size) 1回のクエリで問い合わせるノードの数。kを大きくすると、サンプリング結果がネットワーク全体の意見をより正確に反映するようになり、安全性が向上しますが通信のオーバーヘッドが増加します。α(Alpha / Quorum Size) 多数派を形成したと見なすために必要な最小票数 (α > k/2)。αをkに近づけるほど、決定に対する確信度が高まりビザンチン耐性が向上します(安全性向上)。 しかし、ネットワーク遅延などで一部の応答が欠けた場合に多数派を形成しにくくなり、意思決定が停滞するリスクが高まります(ライブネス低下)。β(Beta / Decision Threshold) トランザクションを承認するために必要な連続成功クエリ回数。βを大きくすると、承認までにより多くの証拠(連続した多数派支持)が必要になるため、誤った決定がなされる確率が劇的に低下します(安全性向上)。 しかし、ファイナリティに達するまでの時間が長くなります(レイテンシ増大)。
avalanchegoでは、これらのパラメータはsnow/consensus/snowball/parameters.goで定義されています。
// avalanchego/snow/consensus/snowball/parameters.go

// Parameters required for snowball consensus
type Parameters struct {
	// K is the number of nodes to query and sample in a round.
	K int `json:"k" yaml:"k"`
	// Alpha is used for backwards compatibility purposes and is only referenced
	// during json parsing.
	Alpha *int `json:"alpha,omitempty" yaml:"alpha,omitempty"`
	// AlphaPreference is the vote threshold to change your preference.
	AlphaPreference int `json:"alphaPreference" yaml:"alphaPreference"`
	// AlphaConfidence is the vote threshold to increase your confidence.
	AlphaConfidence int `json:"alphaConfidence" yaml:"alphaConfidence"`
	// Beta is the number of consecutive successful queries required for
	// finalization.
	Beta int `json:"beta" yaml:"beta"`
	// ConcurrentRepolls is the number of outstanding polls the engine will
	// target to have while there is something processing.
	ConcurrentRepolls int `json:"concurrentRepolls" yaml:"concurrentRepolls"`
	// OptimalProcessing is used to limit block creation when a large number of
	// blocks are processing.
	OptimalProcessing int `json:"optimalProcessing" yaml:"optimalProcessing"`

	// Reports unhealthy if more than this number of items are outstanding.
	MaxOutstandingItems int `json:"maxOutstandingItems" yaml:"maxOutstandingItems"`

	// Reports unhealthy if there is an item processing for longer than this
	// duration.
	MaxItemProcessingTime time.Duration `json:"maxItemProcessingTime" yaml:"maxItemProcessingTime"`
}コンセンサスプロセス
対立がない場合
ネットワークに二重支払いのような対立するトランザクションが存在しない場合、コンセンサスは迅速に進みます。
- 正直なノードAが新しいトランザクションTx1を受け取ります。
- ノードAはTx1を支持し、
K個のノードにクエリを送信します。 - クエリを受け取った他の正直なノードもTx1しか知らないため、全員がTx1を支持すると応答します。
- ノードAは
K個の応答(K >= Alpha)を受け取り、これは成功したクエリとなります。Beta回このプロセスを繰り返すと、Tx1は極めて迅速に承認されます。
対立がある場合
Conflict Set {Tx1, Tx2} が存在する場合(二重支払い)、Snowの対立解決メカニズムが機能します。
- 異なるノードがそれぞれ対立するTx1とTx2を最初に受信するため、ネットワークは支持するトランザクションが分かれた状態(メタステーブル状態)から始まります。
- Tx1を支持するノードAがクエリを行うと、サンプリングのランダム性によりTx1を支持する応答が
α票以上になる可能性があります。 - この結果を受け、ノードAはTx1に対する内部のカウンターを更新します。
- このクエリ対象にTx2を支持していたノードが含まれていた場合、そのノードは多数派の意見であるTx1へと自身の支持対象を変更する可能性があります。
- これにより、ネットワーク全体でTx1を支持するノードの割合が増加します。
- このプロセスが繰り返されることで、Tx1を支持するノードが増えるほど、その後のクエリでTx1が多数派になる確率も高まります。 その結果、一方のトランザクションへの支持がさらに増加していきます。
- 最終的に、全ての正直なノードが一方のトランザクション(この場合Tx1)を承認し、対立していたTx2は拒否されます。
主な特性
確率的安全性
Snowは、決定論的な安全性を保証する代わりに、「無視できるほど低い確率 (イプシロン)でしか合意が覆らない」という確率的な安全性を持ちます。
この失敗確率εは、K, Alpha, Betaと、ネットワーク内のビザンチンノードの割合fの関数であり、パラメータを調整することで天文学的に低い値に設定可能です。
"Unlike classical consensus protocols, ... we adopt an ε-safety guarantee that is probabilistic." — Avalanche Consensus Whitepaper
高いスケーラビリティ
各ノードが1回のクエリで通信する相手は、ネットワーク全体のノード数nに関わらず、常に一定のKです。
これにより、通信のオーバーヘッドはO(K)(nに対してはO(1))に抑えられ、ノード数が増加しても性能がほとんど低下しません。
"each node requires O(1) communication overhead per round... whereas classical consensus protocols... require O(n) communication per round" — Avalanche Consensus Whitepaper
リーダーレス
Snowには、特定の「リーダー」が存在しません。 全てのノードが対等な立場でプロトコルに参加するため、特定のノードに障害が発生してもシステム全体が停止するリスク(単一障害点)がなく、システムの分散性と堅牢性(障害に対する耐性)が向上します。
静止状態
これはPoWと比較して非常に重要な特性です。 処理すべきトランザクションが存在しない場合、Snowプロトコルは一時停止します。 つまり、ノードはクエリを行わず、CPUやネットワークリソースをほとんど消費しません。 これにより高いエネルギー効率が実現されます。
"Unlike blockchains that rely on proof-of-work, they are quiescent and green." — Avalanche Consensus Whitepaper
Slush
Slushは、Snowプロトコルファミリーの最も基本的なアルゴリズムです。 このプロトコル自体はビザンチン耐性を持ちませんが、メタスタビリティとサブサンプリングというAvalancheのコア機能がどのように動作するかを理解するための重要なモデルとなります。
仕組み
Slushは、対立する複数の選択肢(ホワイトペーパーでは説明のため「色」として表現)のうち、どれか1つにネットワーク全体で合意するプロセスをモデル化します。
- 初期状態 各ノードは、どの色も支持していない「未決定(Uncolored)」の状態から始まります。
- クエリの開始 ノードがクライアントから新しいトランザクション(例:「赤」に対応)を受信すると、自身の状態を「赤」に更新し、クエリプロセスを開始します。
- サンプリングとクエリ
ノードは、ネットワークからランダムに
k個のノードをサンプリングし、それらのノードに現在支持している色を尋ねるクエリを送信します。 - 状態の更新
k個のノードから応答を受け取り、その結果を集計します。 もし、ある色(例:「青」)への支持がα票以上に達した場合、ノードは自身の状態をその多数派の色(「青」)に書き換え(フリップ)ます。 - 決定
このクエリと更新のプロセスを、事前に定められた固定回数
mラウンド繰り返します。mラウンドが終了した時点でノードが支持している色が、そのノードの最終的な決定となります。
この固定回数 m に依存する点が、Slushの構造を単純にしていますが同時に弱点でもあります。
正しいノードのみが存在するネットワークでは機能しますが、ビザンチンノードが存在する環境では、最適な m を決定することが難しくなります。
"Slush makes progress under any network configuration... since random perturbations in sampling will cause one color to gain a slight edge and repeated samplings afterwards will build upon and amplify that imbalance."
Slushは、たとえネットワーク全体の意見が完全に二分している(例:50対50)状況からでも、合意形成を進めることができます。 これは、ランダムなサンプリングによって確率的に生じるわずかな票の偏りがきっかけとなるためです。 一度、ある選択肢がわずかに優勢になると、後続のサンプリングでもその選択肢が多数派として選ばれる可能性が高まります。 このプロセスが繰り返されることで、最初の小さな不均衡が増幅され、最終的にネットワーク全体が一つの意見へと集約されていきます。
実装
Slushは概念的なモデルであり、avalanchegoで直接使用されることはありません。
しかし、そのロジックはより高度なプロトコルであるSnowflakeとSnowballの構成要素として組み込まれています。
実装はsnow/consensus/snowball/ディレクトリ内にあり、2値(バイナリ)決定用と多値(Nナリ)決定用の2種類が用意されています。
2値決定
2つの選択肢(コード内では0と1)の間で合意を形成する最も単純な実装です。
preferenceフィールドが現在の支持対象を保持し、RecordSuccessfulPollが呼ばれると無条件に新しい選択肢で上書きされます。
// avalanchego/snow/consensus/snowball/binary_slush.go

type binarySlush struct {
	preference int
}

func (sl *binarySlush) Preference() int {
	return sl.preference
}

func (sl *binarySlush) RecordSuccessfulPoll(choice int) {
	sl.preference = choice
}多値決定
3つ以上の選択肢を扱う実装です。
各選択肢はids.IDで表現され、基本的なロジックはbinarySlushと同じです。
// avalanchego/snow/consensus/snowball/nnary_slush.go

type nnarySlush struct {
	preference ids.ID
}

func (sl *nnarySlush) Preference() ids.ID {
	return sl.preference
}

func (sl *nnarySlush) RecordSuccessfulPoll(choice ids.ID) {
	sl.preference = choice
}このSlushのロジックは、binary_snowflake.goで以下のように構造体として埋め込まれており、SnowflakeがSlushを基盤としていることが分かります。
// avalanchego/snow/consensus/snowball/binary_snowflake.go

type binarySnowflake struct {
	// wrap the binary slush logic
	binarySlush

	// ... (Snowflake specific fields)
}ビザンチン耐性の欠如
Slushの決定的な弱点は、ビザンチン耐性がないことです。 悪意のあるノード(ビザンチンノード)はプロトコルに完全に従う必要がなく、戦略的に応答を操作して合意形成を妨害できます。
ネットワークの意見がある選択肢に傾き始めた場合、ビザンチンノードは意図的に対立する選択肢を応答し続けることで多数派の形成を妨げます。 これにより、ネットワークを永続的にメタスタビリティの状態(意見が拮抗した状態)に留め、最終的な決定に至ることを阻止できます。
"The Slush protocol does not provide a strong safety guarantee in the presence of Byzantine nodes. In particular, if the correct nodes develop a preference for one color, a Byzantine adversary can attempt to flip nodes to the opposite so as to keep the network in balance, preventing a decision." (Slushプロトコルは、ビザンチンノードが存在する状況では強力な安全性を保証しない。特に、正しいノードがある色への選好を強めた場合、ビザンチン攻撃者は反対の色にノードをフリップさせ、ネットワークを均衡状態に保ち、決定を妨げようと試みることができる。)
この課題を克服するため、次のプロトコルであるSnowflakeが考案されました。
Snowflake
Snowflakeは、Slushを拡張してビザンチン耐性を追加したプロトコルです。 Slushのサブサンプリングというコア機能はそのままに、各ノードが自身の支持を追跡するためのカウンターを追加することで、悪意のあるノードからの攻撃に対する堅牢性を高めています。
コアメカニズム
Slushの弱点は、各ノードが過去のクエリ結果を記憶しない点にありました。 これにより、ビザンチンノードは意図的に対立する意見を返すことで、正直なノードの支持を容易に覆し、合意形成を妨害できました。
Snowflakeは、この問題を解決するために consecutiveSuccesses(連続成功回数)という状態を各ノードに持たせます。
これは、ある選択肢に対して、連続して多数派の支持を得た回数を記録するカウンターです。
このカウンターの導入により、プロトコルの動作は以下のように変化します。
- カウンターの増加 クエリの結果、多数派の選択肢が自身の現在の支持対象と同じであれば、カウンターをインクリメントします。
- カウンターのリセット
多数派の選択肢が自身の支持対象と異なる場合、その新しい選択肢に支持を切り替え、カウンターを1にリセットします。
これは、新しい支持対象に対する最初の成功と見なされるためです。
クエリで
α票以上の多数派が形成されなかった場合、どの選択肢への支持も確固たるものではないと見なされ、カウンターは0にリセットされます。 - 決定(ファイナライズ)
カウンターの値が、事前に定められたしきい値
β(ベータ)に達すると、ノードは現在の支持対象を最終的な決定として「承認(Accept)」します。 一度この状態になると、finalizedフラグが立てられ、以降そのノードの決定は覆りません。
Snowflake augments Slush with a single counter that captures the strength of a node’s conviction in its current color.
ホワイトペーパーでは、Snowflakeがノードの現在の支持対象に対する支持の強さを記録するための単一のカウンターをSlushに追加することで、機能を拡張したことを説明しています。
実装
Snowflakeのロジックはsnow/consensus/snowball/ディレクトリ内に実装されています。
2値決定を行うbinary_snowflake.goと多値決定を行うnnary_snowflake.goが存在しますが、ここではより理解しやすいbinary_snowflakeを中心に解説します。
// avalanchego/snow/consensus/snowball/binary_snowflake.go

// binarySnowflake is the implementation of a binary snowflake instance
type binarySnowflake struct {
	// wrap the binary slush logic
	binarySlush

	// alphaPreference is the threshold required to update the preference
	alphaPreference int

	// ...

	// confidence is the number of consecutive successful polls for a given
	// alphaConfidence threshold.
	confidence []int

	// finalized prevents the state from changing after the required number of
	// consecutive polls has been reached
	finalized bool
}binarySnowflake構造体は、binarySlush構造体をフィールドとして埋め込むことでその機能を取り込み、さらにconfidence(連続成功カウンターに相当)とfinalizedフラグという新たなフィールドを追加して構成されています。
次にコアロジックであるRecordPoll関数を見ていきます。
// avalanchego/snow/consensus/snowball/binary_snowflake.go

func (sf *binarySnowflake) RecordPoll(count, choice int) {
	if sf.finalized {
		return // 既に決定済みであれば何もしない
	}

	// [alphaPreference]は、自身の支持を変更するために最低限必要な票数。
	// これに満たない場合は失敗したクエリと見なす。
	if count < sf.alphaPreference {
		sf.RecordUnsuccessfulPoll() // confidenceカウンターを0にリセット
		return
	}

	// 自身の支持対象(preference)と異なる選択肢が多数派だった場合、
	// これまでのconfidenceをリセットする。
	if choice != sf.Preference() {
		clear(sf.confidence)
	}
	// Slushのロジックを呼び出し、支持対象を更新する。
	sf.binarySlush.RecordSuccessfulPoll(choice)

	// terminationConditionsは{alphaConfidence, beta}のペアのリスト。
	// これにより、複数の決定条件を設定できる。
	for i, terminationCondition := range sf.terminationConditions {
		// クエリの票数が、このレベルの信頼度を得るための閾値[alphaConfidence]に
		// 満たない場合、これ以降のより厳しい条件も満たさないため、
		// 対応するカウンター以降をクリアして終了する。
		if count < terminationCondition.alphaConfidence {
			clear(sf.confidence[i:])
			return
		}

		// 閾値に達していれば、カウンターをインクリメント
		sf.confidence[i]++
		// カウンターが決定閾値[beta]に達したか確認
		if sf.confidence[i] >= terminationCondition.beta {
			sf.finalized = true // 承認
			return
		}
	}
}

func (sf *binarySnowflake) RecordUnsuccessfulPoll() {
	clear(sf.confidence)
}この実装から、以下のことがわかります。
- クエリの票数が
alphaPreferenceに満たない場合は、失敗したクエリと見なされてconfidenceカウンターが0にリセットされる。 - 自身の支持対象(
Preference)と異なる選択肢が多数派になった場合も、カウンターは0から再スタートする。 - 同じ選択肢への支持が続き、
confidenceカウンターがbetaに達するとfinalizedフラグがtrueになり、決定が確定する。
Slushからの改良点と限界
SnowflakeはSlushに対して以下の重要な改良を加えています。
- 状態の導入
Slushが各ラウンドでほぼ状態を持たないのに対し、Snowflakeは
confidenceカウンターという形で過去のクエリ結果の履歴を保持します。 これがプロトコルの状態となり、意思決定に一貫性をもたらします。 - 動的な終了条件
Slushが固定回数
mラウンドで終了するのに対し、Snowflakeはconfidenceカウンターがβに達するまで動作を続けます。 これにより、ネットワークの状態に応じて終了タイミングが決定されます。 - ビザンチン耐性の獲得
confidenceカウンターの蓄積が必要なため、ビザンチンノードが一時的に多数派を形成しても、正直なノードの決定を容易に覆すことができなくなります。 一度confidenceが蓄積されると、それをリセットするには対立する選択肢で一貫して多数派を形成する必要があり、これは正直なノードが多数を占めるネットワークでは困難です。
しかし、Snowflakeにも限界があります。
confidenceカウンターは一時的なものであり、一度でも対立する選択肢がalphaPreference以上の票を獲得すると、それまでに蓄積したconfidenceは完全にリセットされてしまいます。
ネットワークの意見が拮抗している状況では、confidenceの蓄積とリセットが繰り返されてファイナリティに達するまでに時間がかかる可能性があります。
Snowflake’s notion of state is ephemeral: the counter gets reset with every color flip.
ホワイトペーパーでは上記のように述べられています。 これは、Snowflakeの状態が一時的なものであり、支持対象が切り替わるたびにカウンターがリセットされるという性質を指摘しています。 この課題を解決するため、過去の支持履歴をより継続的に保持するSnowballが考案されました。
Snowball
Snowballは、Snowflakeプロトコルをさらに改良し、より堅牢な合意形成メカニズムを構築したアルゴリズムです。 Snowflakeの課題であった「リセットされやすいカウンター」の問題を、過去の投票履歴をより永続的に記録する仕組みを導入することで解決しています。
コアメカニズム
Snowballは、意思決定プロセスを「長期的な信頼の蓄積」と「短期的な最終決定」という2つのフェーズに分離することで堅牢性を高めています。
- 信頼カウンター (
preferenceStrength) 各ノードは、対立する選択肢ごとに「信頼度」を記録するpreferenceStrengthカウンターを持ちます。 クエリでalphaPreference票以上を得た選択肢があれば、現在の支持対象に関わらずその選択肢の信頼カウンターをインクリメントします。 このカウンターは、支持対象が変わってもリセットされず、長期的な支持の履歴を蓄積します。 - 支持対象 (
preference) ノードは、preferenceStrengthの値が最も高い選択肢を自身の現在の支持対象(preference)とします。 これにより、一時的なサンプリングの偏りではなく、過去からの蓄積された支持履歴に基づいてより安定した支持対象を決定できます。 - 最終決定プロセス (Snowflakeロジック):
最終的な「承認(Accept)」のロジックは、Snowballの構成要素であるSnowflakeインスタンスが担当します。
Snowflakeは自身の
preference(これはSnowballのpreferenceとは独立している)を持ち、クエリで多数派となった選択肢と自身のpreferenceを比較します。 もし両者が一致すれば、連続成功カウンター (confidence) をインクリメントします。 このカウンターがしきい値βに達した時に、その選択肢を最終的に承認します。
この2段階のメカニズムにより、短期的な意見の揺らぎ(Snowflakeのpreferenceの変更)と、長期的な信頼の蓄積(SnowballのpreferenceStrength)が分離され、システム全体として安定した意思決定が可能になります。
実装
avalanchegoの実装はsnow/consensus/snowball/ディレクトリにあります。
binary_snowball.goの構造体とメソッドが、この2段階のメカニズムを明確に示しています。
// avalanchego/snow/consensus/snowball/binary_snowball.go

type binarySnowball struct {
	// wrap the binary snowflake logic
	binarySnowflake

	preference         int
	preferenceStrength [2]int
}binarySnowball構造体は、binarySnowflakeの機能とフィールドを全て含み、さらに自身のpreferenceと信頼度を記録するpreferenceStrength配列をフィールドとして追加しています。
RecordPoll メソッド
RecordPollは、クエリ結果を処理する関数です。
// avalanchego/snow/consensus/snowball/binary_snowball.go

func (sb *binarySnowball) RecordPoll(count, choice int) {
	// パラメータ [alphaPreference] は、長期的な信頼度を更新するための閾値。
	if count >= sb.alphaPreference {
		// 多数派となった選択肢[choice]の信頼度[preferenceStrength]をインクリメント。
		sb.preferenceStrength[choice]++
		// もし[choice]の信頼度が、対立する選択肢の信頼度を上回った場合、
		// Snowballとしての支持対象[preference]を更新する。
		if sb.preferenceStrength[choice] > sb.preferenceStrength[1-choice] {
			sb.preference = choice
		}
	}
	// 埋め込まれたSnowflakeインスタンスのRecordPollを呼び出す。
	// この内部では、[alphaConfidence]パラメータが使用され、
	// 最終決定のための連続成功カウンター[confidence]が更新される。
	sb.binarySnowflake.RecordPoll(count, choice)
}このコードから、alphaPreferenceはSnowballの長期的な支持を決定するために使われ、Snowflake内部で使われるalphaConfidenceは短期的な最終決定プロセスで使われる、という役割分担が読み取れます。
これにより、例えば「過半数の支持があれば長期的な信頼は増すが、決定するにはより厳しい条件(例:8割の支持)を求める」といった柔軟な設定が可能です。
Preference メソッド
このメソッドは、SnowballとSnowflakeのpreferenceをどのように使い分けるかを示しています。
// avalanchego/snow/consensus/snowball/binary_snowball.go

func (sb *binarySnowball) Preference() int {
	// Snowflakeがファイナライズした場合、その決定が最終的なものであるため、
	// Snowflakeの支持対象を優先する。
	if sb.Finalized() {
		return sb.binarySnowflake.Preference()
	}
	// まだファイナライズしていない場合は、長期的な信頼度に基づく
	// Snowball自身の支持対象を返す。
	return sb.preference
}通常時は長期的な信頼度に基づく安定したpreferenceを外部に示しつつも、一度Snowflakeがfinalizedになれば、その決定が最優先されるというロジックです。
これにより、確率的にごく稀にSnowballのpreferenceとSnowflakeの最終決定が食い違うケースが発生しても、常に正しい決定が返されることが保証されます。
Snowflakeからの改良点
- 状態の永続性
Snowflakeのカウンターは支持対象が変わるとリセットされましたが、Snowballの
preferenceStrengthは常に加算され続けるため、過去の投票履歴が失われません。 - 意思決定の安定性
preferenceStrengthのわずかな差によって支持対象が安定しやすくなり、一時的なサンプリングの偏りで支持対象が頻繁に切り替わることが減り、合意形成がより効率的に進みます。
このSnowballの堅牢な意思決定メカ-ズムは、DAG(有向非巡回グラフ)構造を持つAvalancheコンセンサスにおいて、対立するトランザクション群(Conflict Set)の中から承認するべきトランザクションを1つだけ選択するための中核的な仕組みとして利用されています。
DAG
DAG(Directed Acyclic Graph、有向非巡回グラフ)は、グラフ理論におけるデータ構造の一種です。
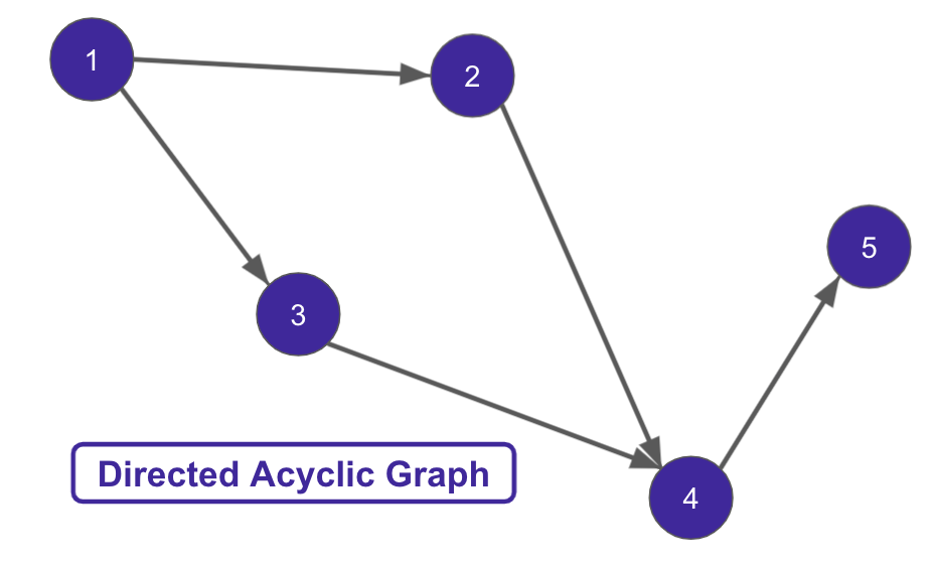
以下の2つの特徴を持ちます。
- 有向(Directed) グラフの各辺(エッジ)には向きがあり、一方の頂点(ノード)からもう一方の頂点へ向かう関係を示します。
- 非巡回(Acyclic) グラフ内のどの頂点から出発しても、辺をたどって同じ頂点に戻ってくる経路(サイクル)が存在しません。
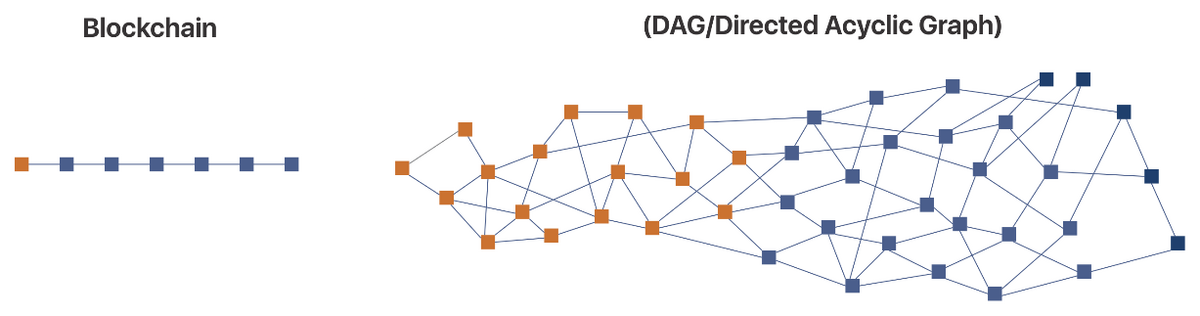
ブロックチェーンがトランザクションを直線的な一本の鎖(チェーン)に記録するのに対し、DAGはトランザクションを網の目のようなグラフ構造で記録します。 これにより、複数のトランザクションを同時に、かつ並列で処理することが可能になり、スループットの向上が期待できます。
AvalancheにおけるDAGの役割
他の多くのDAGベースのプロジェクトとは異なり、AvalancheではDAG構造自体がコンセンサスを形成するわけではありません。 AvalancheにおけるDAGの主な役割は、Snowballコンセンサスプロセスの効率化とセキュリティ強化です。
"In effect, Avalanche executes multiple Snowball (one from the Snow family) instances with the aid of a Directed Acyclic Graph (DAG). The DAG serves to piggyback multiple instances, reducing the cost from O(logn) to O(1) per node and streamlining the path where there are no conflicting transactions."
ホワイトペーパーでは上記のように述べられており、DAGが複数のSnowballインスタンスの実行を補助し、コストを削減するためのものであることがわかります。
投票の効率化:Transitive Voting(推移的投票)
AvalancheのDAGにおける重要な機能は、1つの投票が複数の対象に適用される点です。
- 構造 各頂点(Vertex)は複数のトランザクションを含み、1つ以上の親頂点(Parents)への参照を持ちます。 これにより、頂点間の依存関係がグラフを形成します。
- メカニズム ある頂点(子)への「賛成」票は、その頂点の全ての祖先(親、親の親...)への「賛成」票としても扱われます。
これにより、1回のクエリで、ある頂点とその祖先ツリーに含まれる全てのトランザクション群(実際にはそれらが属する多数のConflict Set)に対して、まとめて投票することができます。 このバッチ処理により、トランザクションあたりの通信オーバーヘッドが大幅に削減されます。
セキュリティの強化
DAG構造は、過去の決定を保護する役割も果たします。
"The DAG intertwines the fate of transactions, similar to the Bitcoin blockchain. This renders past decisions difficult to undo without the approval of correct nodes."
ホワイトペーパーで指摘されているように、各トランザクションの承認状態が相互に依存し合うことで、過去の決定を覆すことが困難になります。 あるトランザクションを不正に承認させようとする場合、そのトランザクションだけでなく、それに依存する後続の多くのトランザクションについても正しいノードの合意を得る必要があり、攻撃の難易度が高まります。
Snowballとの連携
Avalancheコンセンサスでは、各Conflict Setに対して個別のSnowballインスタンスが実行されます。 DAGは、これらの無数のSnowballインスタンスへの投票を効率的に束ねる役割を担います。
ノードが、ある頂点Vに対するクエリに「賛成」と応答するのは、以下の条件が満たされた場合のみです。
- 頂点
Vに含まれる全てのトランザクションが、それぞれのConflict Set内で現在支持されていること。 - 頂点Vから親をたどって到達できる全ての祖先頂点に含まれる全てのトランザクションが、それぞれのConflict Set内で現在支持されていること。
この厳格な条件により、一度でも対立トランザクションで劣勢になった祖先を持つ頂点は、ネットワークからの支持を得ることができなくなります。
他のDAGプロジェクトとの違い
AvalancheのDAGは、他のプロジェクトと異なり、投票結果を記録するものではありません。
信頼度(confidence)は、DAGの構造(子孫の数など)ではなく、Snowballのクエリでα票以上を獲得したという事実(chit)によってのみ蓄積されます。
"Unlike other cryptocurrencies that use graph vertices directly as votes, Avalanche only uses a DAG for the purpose of batching queries in the underlying Snowball instances. Because confidence is built by collected chits, and not by just the presence of a vertex, simply flooding the network with vertices attached to the rejected side of a subgraph will not subvert the protocol."
ホワイトペーパーでは、AvalancheのDAGが投票のバッチ処理ツールであり、信頼度を決定する直接的な要因ではないことが明確に示されています。 これにより、攻撃者が無効なトランザクションを含む多数の頂点をDAGに追加して投票結果を操作しようとする攻撃を防いでいます。
avalanchegoでの実装
Vertexの定義
snow/consensus/avalanche/vertex.go で定義されているVertexインターフェースが、DAGの頂点を表現します。
Parents()メソッドが、親頂点への参照を返すことでグラフ構造を形成します。
// avalanchego/snow/consensus/avalanche/vertex.go

type Vertex interface {
    choices.Decidable

    // Returns the vertices this vertex depends on
    Parents() ([]Vertex, error)

    // ... (other methods)
}エンジンの実装
snow/engine/avalanche/transitive.go がAvalancheコンセンサスエンジンの主要なロジックを担っています。
このエンジンがDAGを維持・検証し、Snowballインスタンス(snow/consensus/avalanche内のConsensusインターフェースとして実装)と連携して合意形成を進めます。
Snowman
Snowmanは、Snowプロトコルファミリーの一員であり、特に線形チェーン(Linear Chain)上での合意形成に特化して設計されたコンセンサスプロトコルです。 AvalancheのC-Chain(EVM)やP-Chainで採用されており、トランザクションの完全な順序付け(Total Order)を保証します。 これは、ステート遷移が直前のステートに依存するスマートコントラクトの実行などに不可欠な特性です。
概要
DAGベースのAvalancheコンセンサスがトランザクションの部分的な順序付けを行うのに対し、Snowmanはブロックを直線的に連なるチェーン構造で管理します。 Snowmanは、Snowballプロトコルを線形チェーンに適用したもので、コンフリクトの扱いがチェーン構造に最適化されています。
- コンフリクトの定義 Snowmanにおけるコンフリクトは、ブロックチェーンのフォークとして発生します。 同じ親ブロックを持つ(=同じ高さに存在する)複数の異なるブロックが提案された場合、それらはConflict Setを形成します。 コンセンサスの目的は、この中から承認すべきブロックを1つだけ選択することです。
- 投票対象 投票の対象は、個別のトランザクションではなくブロックです。
コアメカニズム
Snowmanの実装は、topological.goにある投票集計アルゴリズムに特徴があります。 ブロックチェーンは、親から子への有向な関係を持つグラフ構造(DAG)であり、Snowmanはこの構造を利用して、受け取った投票を効率的に集計します。
投票の連鎖的な効果とKahnのアルゴリズム
あるブロックへの「賛成」票は、そのブロックの全ての祖先ブロックへの「賛成」票としても扱われます。
この集計を効率的に行うため、RecordPollメソッドではKahnのトポロジカルソートアルゴリズムに似たアプローチが採用されます。
Kahnのトポロジカルソートアルゴリズム
DAG(有向非巡回グラフ)の頂点を、その依存関係の順序(トポロジカル順序)に従って線形に並べるためのアルゴリズムです。
ここで、in-degreeとは、ある頂点を指す辺の総数を指します。
Snowmanのコンテキストでは、ブロックチェーンを「子ブロック → 親ブロック」という向きのグラフと見なします。
そのため、あるブロックの in-degree は、そのブロックを親として持つ直接の子ブロックの数に相当します。
アルゴリズムは以下の手順で動作します。
- まず、
in-degreeが0の全ての頂点(つまり、子ブロックを持たない末端のブロック)をキューに追加します。 - 次に、キューから頂点を1つ取り出し、結果のリストに追加します。
- 取り出した頂点から、その親頂点を指している辺をグラフから削除します。
- 辺が削除されたことで、親頂点の
in-degreeが1減少します。これにより新たにin-degreeが0になった頂点(つまり、全ての子ブロックの処理が完了した親ブロック)をキューに追加します。 - キューが空になるまで、ステップ2から4を繰り返します。
このプロセスが完了すると、依存関係の逆順(子から親へ)に並べられた頂点のリストが得られます。Snowmanはこれを利用して、末端のブロックから根元に向かって効率的に票を集計します。
Snowmanでは、このアルゴリズムの考え方を応用し、チェーンの末端(子孫を持たないブロック、in-degreeが0に相当)から親ブロックへと遡って票を集計していきます。
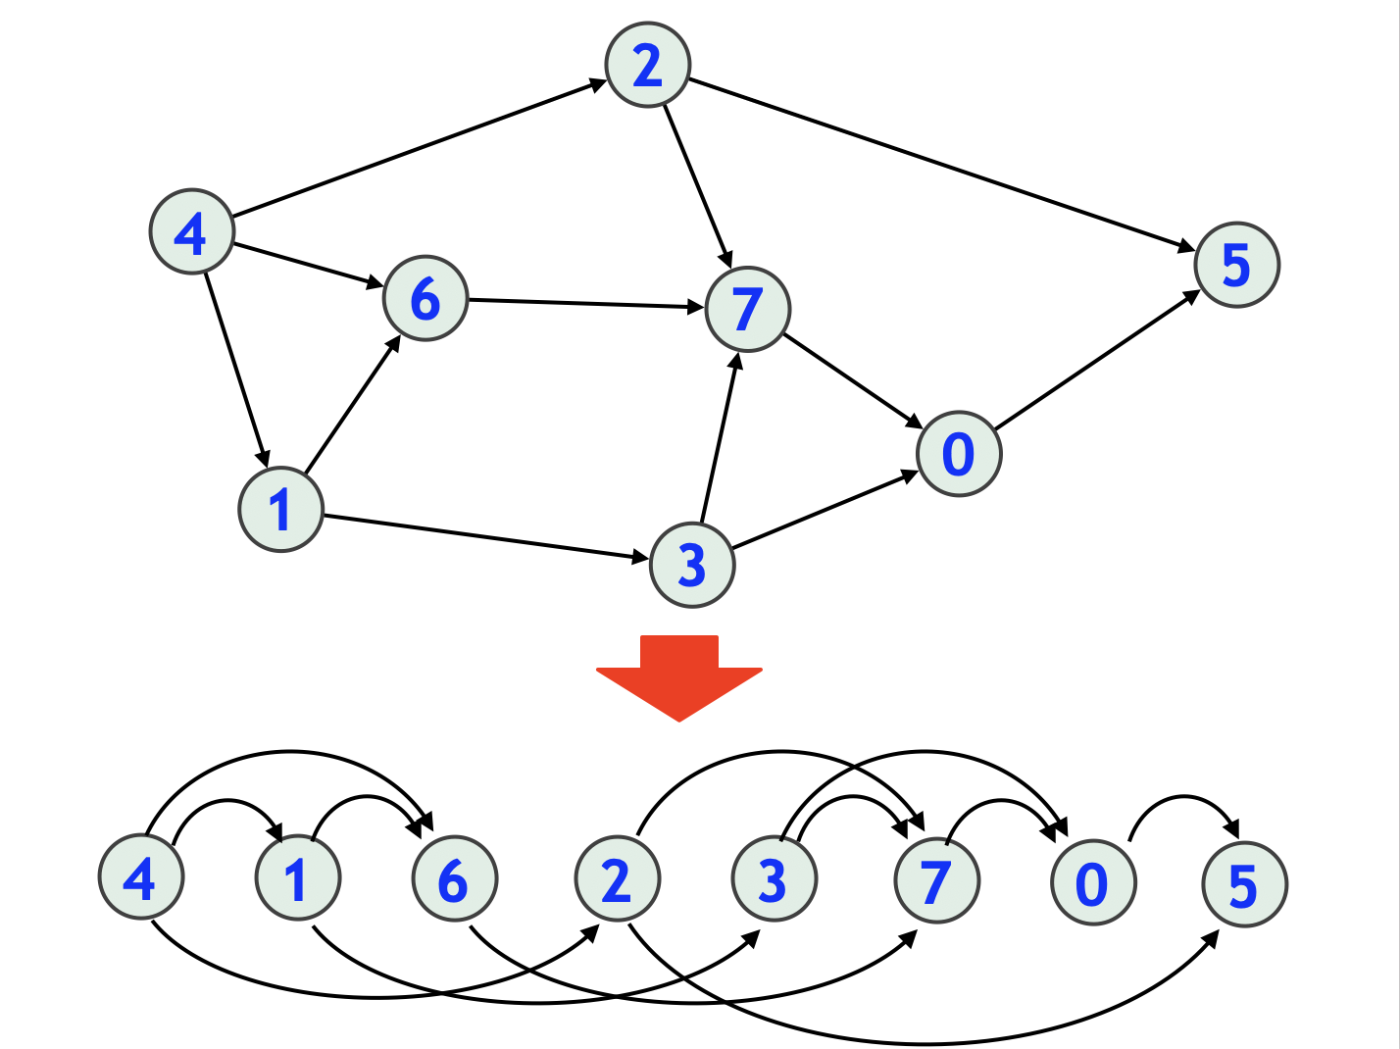
RecordPollメソッドでの投票集計は、以下のステップで行われます。
- 依存関係グラフの構築とin-degreeの計算 (
calculateInDegree) まず、投票があったブロック群から、Parent()をたどって到達可能な全ての祖先ブロックを特定し、処理対象となるブロックの依存関係グラフを作成します。 次に、このグラフ内で各ブロックが持つ子ブロックの数を「in-degree」として計算します。 これは、Kahnのアルゴリズムにおける「入ってくる辺の数」に相当します。 同時に、各ブロックがその直接の子ブロックから何票受け取ったかを記録します。 - 葉からの票の伝播 (
pushVotes) in-degreeが0のブロック(グラフの末端にあるブロック、または全ての子ブロックからの集計が完了したブロック)を「葉」とします。 この葉ブロックから処理を開始し、集計した票を親ブロックに伝播させます。 票を受け取った親ブロックは、自身のin-degreeを1減らします。 この処理によりin-degreeが0になった親ブロックは、新たな「葉」として処理キューに追加されます。 - Snowballインスタンスへの投票適用 (
vote) このプロセスをグラフの根元方向に繰り返すことで、各ブロックが自身の子孫ツリー全体から集めた総票数が効率的に計算されます。 最終的に、総票数がα以上に達したブロックだけが「成功した」と見なされ、そのブロックが持つSnowballインスタンス(sb)のRecordPollメソッドが呼び出されます。 これにより、各フォークポイントでの支持対象(preference)が更新されます。
このアルゴリズムにより、1回の投票でチェーン全体にわたる多数のフォークポイントの状態を一度に更新することが可能になり、高い効率を実現しています。
具体例
- 投票と依存関係グラフの構築
まず、ネットワークから受け取った投票を基に、関連するブロックの依存関係グラフを作成します。
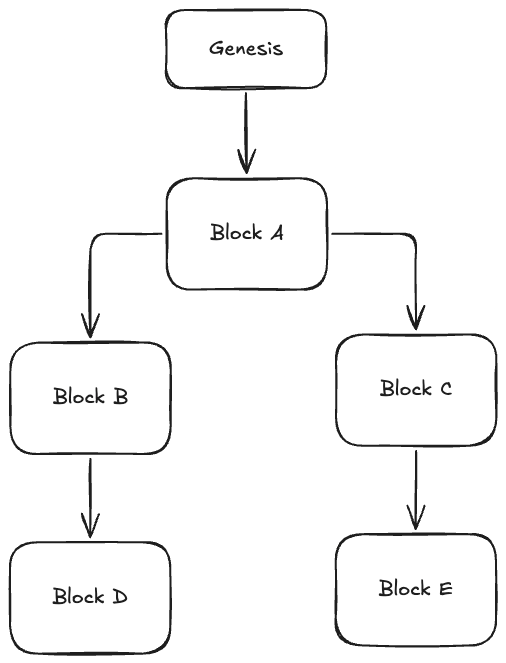
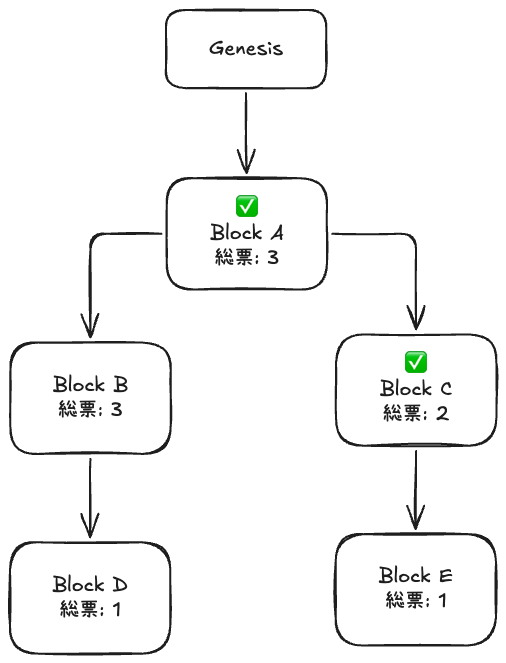
上記のようなチェーンのフォークが存在し、Block D, Block E, Block C に1票ずつ投票があったとします。
この投票から、親ブロックを再帰的にたどることで、関連する全てのブロックを含む処理対象グラフが構築されます。 同時に、各ブロックが持つ直接の子ブロックの数(in-degree)が計算されます。
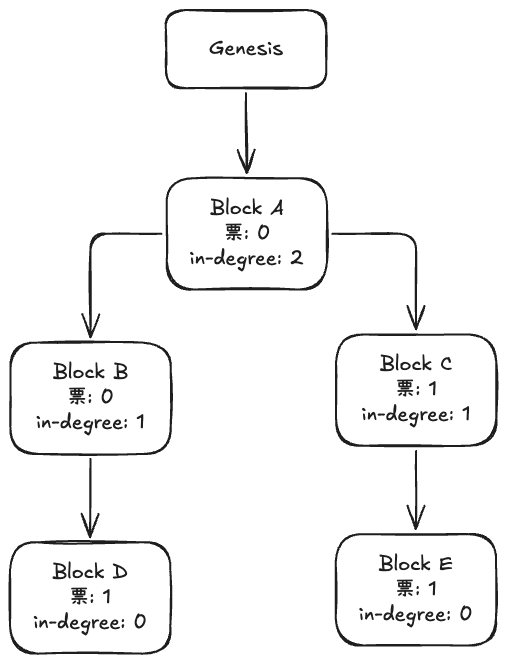
Block D: in-degree = 0, 票 = 1Block E: in-degree = 0, 票 = 1Block C: in-degree = 1 (子: E), 票 = 1Block B: in-degree = 1 (子: D), 票 = 0Block A: in-degree = 2 (子: B, C), 票 = 0
- 葉からの票の伝播
次に、in-degreeが0のブロック(葉)から親ブロックへと票を伝播させます。
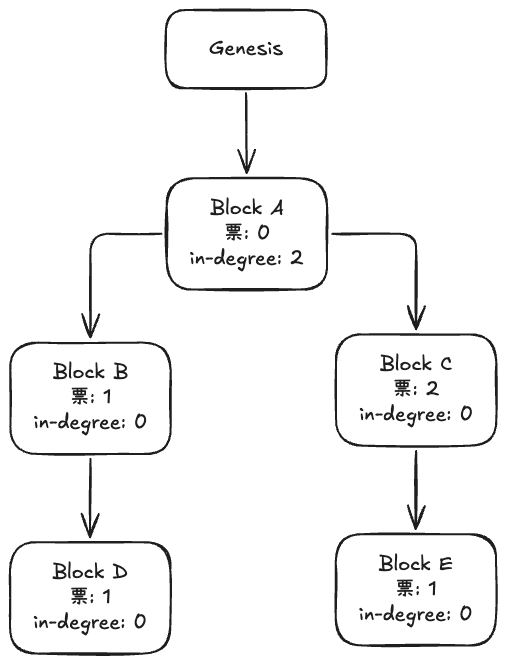
2-1. 最初の葉
Block D と Block E のin-degreeが0なので、これらから処理を開始します。
- Block D (票:1) -> 親の Block B へ票を伝播。
- Block B の票は 0 + 1 = 1 になる。
- Block B のin-degreeは 1 - 1 = 0 になり、新たな葉となる。
- Block E (票:1) -> 親の Block C へ票を伝播。
- Block C の票は 1 + 1 = 2 になる。
- Block C のin-degreeは 1 - 1 = 0 になり、新たな葉となる。
この時点での各ブロックの総票数とin-degree
- Block D: 票 = 1
- Block E: 票 = 1
- Block B: 票 = 1, in-degree = 0 <- 新しい葉
- Block C: 票 = 2, in-degree = 0 <- 新しい葉
- Block A: 票 = 0, in-degree = 2
2-2. 次の葉新たな葉である Block B と Block C から処理を続けます。
- Block B (票:1) -> 親の Block A へ票を伝播。
- Block A の票は 0 + 1 = 1 になる。
- Block A のin-degreeは 2 - 1 = 1 になる。
- Block C (票:2) -> 親の Block A へ票を伝播。
- Block A の票は 1 + 2 = 3 になる。
- Block A のin-degreeは 1 - 1 = 0 になり、新たな葉となる。
**最終的な各ブロックの総票数(子孫からの票を含む)**
- `Block D`: 1票
- `Block E`: 1票
- `Block B`: 1票
- `Block C`: 2票
- `Block A`: 3票
3. Snowballインスタンスへの投票適用
最後に、集計された総票数を基に、各ブロックが持つSnowballインスタンスの状態を更新します。
- 仮に
α = 2とします。 Block A(3票 >= α) ->Block AのSnowballインスタンス(sb)のRecordPollが呼ばれる。フォークBvsCのうち、総票数が多いC(Cの子孫票:2 >Bの子孫票:1) が優勢になる可能性があります。Block C(2票 >= α) ->Block CのSnowballインスタンス(sb)のRecordPollが呼ばれる。Block B(1票 < α) ->RecordPollは呼ばれず、カウンターがリセットされる可能性があります。Block D,Block Eも同様にαと比較されます。
このようにして、1回のネットワーク投票からチェーン全体の各フォークポイントでの支持状況を効率的に更新します
OracleBlockによる最適化
Snowmanは、OracleBlockという特殊なブロックを扱うことで、コンセンサスをさらに最適化できます。
// avalanchego/snow/consensus/snowman/oracle_block.go
type OracleBlock interface {
	Options(context.Context) ([2]Block, error)
}OracleBlockは、次に続くブロックの選択肢が2つしかないことをVMが事前に分かっている場合に実装されます。
例えば、Platform VMでは、バリデーターの追加などを提案する「提案ブロック」の後に、その提案を確定させるための「Commitブロック」と取り消すための「Abortブロック」のどちらを承認するかが問われます。
このように、次に続くブロックの選択肢が「Commit」か「Abort」の2つに限定されることが事前に分かっているため、SnowmanはOracleBlockとしてこの状況を扱います。
通常、3つ以上の選択肢があり得るフォークでは、どの選択肢にも対応できる汎用的なデータ構造(snowball.Tree)が使われます。
しかし、選択肢が2つしかない場合は、より単純で効率的な2値決定専用のSnowballインスタンスを使用できます。
これにより、コンセンサスプロセスにおける計算や管理のオーバーヘッドが削減され、処理が高速化されます。
実装
avalanchegoにおけるSnowmanの実装は、snow/consensus/snowman/ディレクトリにあります。
Block インターフェース
Snowmanが扱うブロックは、線形チェーンの特性を反映したBlockインターフェースを満たします。
// avalanchego/snow/consensus/snowman/block.go
type Block interface {
	snow.Decidable
	Parent() ids.ID
	Height() uint64
	// ...
}Parent()が単一のIDを返す点が、複数の親を持つDAGのVertexとの決定的な違いです。
DAGベースのAvalancheコンセンサスでは、VertexインターフェースのParents()メソッドは複数の親IDのスライス([]Vertex)を返します。
これにより、複数の先行トランザクションに依存するグラフ構造を表現できます。
一方、SnowmanのBlockインターフェースはParent()で単一のIDしか返さないため、各ブロックが必ず一つの親しか持たない直線的なチェーン構造であることが保証されます。
snowmanBlock と snowball.Consensus
topological.go内のsnowmanBlock構造体が、各ブロックの状態を管理します。
重要なのは、snowball.Consensus型のフィールドsbを保持している点です。
// avalanchego/snow/consensus/snowman/snowman_block.go
type snowmanBlock struct {
	// ...
	sb snowball.Consensus
	children map[ids.ID]Block
}このsbフィールドは、このブロックを親とする全ての子ブロック群(つまり、フォークして対立関係にあるブロック群)の中から、どれを承認するかを決定するためのSnowballインスタンスです。
新しい子ブロックが追加されるたびに、このSnowballインスタンスに選択肢として追加されます。
SnowmanとAvalanche(DAG)の使い分け
- Snowman (線形チェーン) トランザクションの完全な順序付けが必要なVMに適しています。 全ての参加者が同じ順序でステートを遷移させる必要があるEVM(C-Chain)や、バリデーターセットの追加・削除を厳密な順序で管理するPlatform VM(P-Chain)で採用されています。
- Avalanche (DAG) トランザクション間に依存関係がない場合、並列処理によるスループット向上が見込める場合に適していました。 かつてのX-Chain(UTXOベース)で採用されていましたが、Cortinaアップグレードにより現在はX-ChainもSnowman++(線形化されたDAG)上で動作しており、Avalancheコンセンサスの利点を取り入れつつよりシンプルな運用が可能になっています。
この使い分けにより、Avalancheはアプリケーションの要件に応じて最適なコンセンサスモデルを提供できる柔軟性を持っています。
Snowman++
Snowman++は、Snowmanコンセンサスプロトコルに輻輳制御(Congestion Control)のメカニズムを追加した改良版です。
この機能は、既存のSnowmanベースのVMにコードの変更を加えることなく、proposerVMと呼ばれるラッパーVMを介して導入されます。
C-Chainなど、ブロック生成が頻繁に行われるチェーンにおいて、パフォーマンスと安定性を向上させることを目的としています。
輻輳制御
ネットワークの世界における「輻輳」とは、処理能力を超える大量のデータ(この場合はトランザクションやブロック提案)が殺到し、通信の遅延や詰まりが発生している状態を指します。
Avalancheコンセンサスの文脈では、多数のバリデーターが同時にブロックを提案することでネットワーク上に多数のフォーク(コンフリクト)が発生し、合意形成の効率が低下する状況がこれにあたります。
輻輳制御(Congestion Control) とは、このような輻輳の発生を検知してデータの送信量を調整することでネットワークの混雑を緩和し、システム全体のパフォーマンスを安定させるための仕組み全般を指します。 Snowman++は、ブロックを提案できるノードを一時的に制限することで、この輻輳を制御しています。
コンフリクト削減による輻輳制御
Snowmanコンセンサスでは、どのバリデーターもいつでも新しいブロックを提案できます。 ネットワークが混雑し、複数のバリデーターがほぼ同時に異なるブロックを提案すると、多くのフォーク(コンフリクト)が発生します。 コンフリクトが増加すると、ネットワークがどのチェーンを承認すべきかについて合意を形成するまでの時間(time-to-finality)が増大し、レイテンシが悪化する原因となります。
Snowman++は、この問題を解決するために、ブロックを提案できるノードを一時的に制限するソフトプロポーザーメカニズムを導入します。 これにより、コンフリクトの発生そのものを抑制し、ファイナリティまでの時間を短縮します。
実装: proposerVM
Snowman++は、vms/proposervm/vm.goで実装されているproposerVMによって実現されます。このVMは、本来のVM(例: EVM、「Inner VM」と呼ばれる)をラップし、コンセンサスエンジンとの間のやり取りに介在します。
ブロック構造 (proposervm.Block)
proposerVMは、Inner VMが生成したブロックにSnowman++ヘッダーを追加し、新しいブロックIDを持つproposervm.Blockとして扱います。
postForkBlockはSnowman++有効化後の標準ブロックです。
// vms/proposervm/block/block.go

// postForkBlock is a block that is verified after the fork. It is signed by a
// validator that is allowed to propose at the specified time.
type postForkBlock struct {
	InnerBlock []byte `serialize:"true"`

	PChainHeight uint64 `serialize:"true"`
	Timestamp    uint64 `serialize:"true"`

	Proposer    ids.NodeID `serialize:"true"`
	proposerSig [bls.SignatureLen]byte
}InnerBlock本来のVMが生成したブロックのバイトデータ。PChainHeightプロポーザーリストを決定するために参照したP-Chainのブロック高。Timestampブロックの生成時刻。 タイムウィンドウの検証に使用されます。Proposerこのブロックを生成したバリデーターのNodeIDと署名。
タイムウィンドウ(Submission Window)とは、Snowman++において選出された各プロポーザー(ブロック提案者)がブロックを提案することが許可された、特定の時間帯のことです。
具体的には、親ブロックのタイムスタンプを基準として、以下のように各プロポーザーに時間枠が割り当てられます。
-
前提
- プロポーザーリスト
[P1, P2, P3, ...] - タイムウィンドウの長さ (
WindowDuration) 5秒
- プロポーザーリスト
-
各プロポーザーの提案可能時間
- P1
親ブロックのタイムスタンプ +
0秒~+5秒 - P2
親ブロックのタイムスタンプ +
5秒~+10秒 - P3
親ブロックのタイムスタンプ +
10秒~+15秒 - ...
- P1
親ブロックのタイムスタンプ +
各プロポーザーは、自身のウィンドウが開始するまでブロックを提案することはできません。
この仕組みには2つの主要な目的があります。
- コンフリクトの抑制 全てのバリデーターが同時にブロックを提案するのではなく、指定されたプロポーザーが順番に提案することで、ブロック提案の無秩序な競合を防ぎます。 これにより、同じ高さで複数のブロックが生成される(フォークが発生する)確率を下げ、輻輳を制御します。
- ライブネスの保証 もし指定されたプロポーザー全員がオフラインなどでブロックを提案しなかった場合でも、最後のプロポーザーのウィンドウが終了した後には、どのバリデーターでもブロックを提案できるようになります。 これにより、チェーンが停止することなく進行し続けることが保証されます。
プロポーザー選出
プロポーザーの選出ロジックはvms/proposervm/proposer/windower.goに実装されています。
Windowerは、次のプロセスのためのプロポーザーを決定論的に計算します。
- 親ブロックのヘッダーから
PChainHeightを取得し、その時点でのサブネットのバリデーターリストをP-Chainから取得します。 - 親ブロックの高さとチェーンIDから計算したシード値を使い、バリデーターリストをステーク量で重み付けしてシャッフルします。
- シャッフルされたリストの先頭から
maxWindows(通常6)人のバリデーターをプロポーザーとして選出します。
このプロセスは全てのノードで同じ結果を算出できるため、ネットワーク全体で誰が次のプロポーザーであるかについて別途コンセンサスを得る必要がありません。
BuildBlockへの介在
proposerVMの最も重要な機能の一つが、コンセンサスエンジンからのBuildBlock呼び出しへの介在です。
// vms/proposervm/vm.go

func (vm *VM) BuildBlock(ctx context.Context) (snowman.Block, error) {
	// ... (Pre-fork logic is omitted for clarity)

	// In post-fork, we can only build a block if we are the proposer.
	// Pre-calculating the P-Chain height and the timestamp here avoids
	// re-calculating them inside shouldBuild.
	pChainHeight, err := vm.ctx.ValidatorState.GetCurrentHeight(ctx)
	if err != nil {
		return nil, fmt.Errorf("failed to get current P-Chain height: %w", err)
	}
	parentID := vm.lastAcceptedID
	now := vm.Clock.Time()

	delay, should, err := vm.delay(ctx, parentID, pChainHeight)
	if err != nil {
		return nil, err
	}
	if !should {
		return nil, errProposerNotAllowedToPropose
	}
	time.Sleep(delay)

	// ...

	// The innerVM builds the block
	innerBlk, err := vm.ChainVM.BuildBlock(ctx)
	if err != nil {
		return nil, err
	}

	// We are building a block on top of the last accepted block
	return vm.buildBlock(parentID, pChainHeight, now.Unix(), innerBlk)
}- コンセンサスエンジンが
proposerVM.BuildBlock()を呼び出します。 proposerVMは、vm.delay()を呼び出して、自ノードが現在のタイムウィンドウで正当なプロポーザーであるかを確認します。 もしそうでなければerrProposerNotAllowedToProposeを返し、ブロック生成を中止します。- もし正当なプロポーザーであれば、
vm.ChainVM.BuildBlock()(Inner VMのBuildBlock)を呼び出して、本来のブロック(innerBlk)を生成させます。 vm.buildBlock()内部でinnerBlkをpostForkBlockでラップし、Timestampや自身の署名を含むヘッダーを付与して、コンセンサスエンジンに返します。
この仕組みにより、ブロック生成がプロポーザーリストに従って制御されます。
ソフトプロポーザーとライブネス保証
このメカニズムがソフトプロポーザーと呼ばれる理由は、プロポーザーがブロックを生成しなかった場合のフォールバック機能にあります。
- 各プロポーザーには、
WindowDuration(例: 5秒)のタイムウィンドウが順番に割り当てられます。 - 最後のプロポーザーのウィンドウが終了した後(
maxWindows * WindowDuration後)、どのバリデーターでもブロックを提案することが許可されます。
これにより、指定されたプロポーザーがオフラインであるなどの理由でブロックを生成できなくても、チェーンが停止することなく進行し続けるライブネスが保証されます。
Snowman++の効果
C-Chainのメインネットデータを見ると、Snowman++が有効化された後、1分あたりの拒否ブロック数が劇的に減少していることが確認できます。 これは、プロポーザーメカニズムによって不要なフォークの発生が抑制され、ネットワークが無駄な投票を行うことなく、効率的に単一のチェーンに合意できていることを示しています。
これにより、トランザクションのファイナリティまでの時間が安定し、ネットワーク全体のパフォーマンスとユーザーエクスペリエンスが向上しました。
デモ
上記のデモサイトでAvalancheコンセンサスの動作を確認できます。
画面の下の方にパラメータと実行ボタンがあります。 各パラメータは以下です。
コンセンサスパラメータ
これらはSnowballプロトコルのコアをなすパラメータです。
n(Number of Nodes) ネットワークに参加している総ノード(デモでは四角形)の数で、400に固定されています。 この値が大きいほど、より大規模で分散したネットワークをシミュレートします。 Snowプロトコルはnの数に性能が左右されにくい(スケーラブルである)点が特徴です。k(Sample Size) 1回のクエリで、各ノードがランダムに意見を問い合わせるノードの数です。 ノードはネットワーク全体(n個)ではなく、このk個のノードにのみクエリを送信します。 この値はnより大幅に小さく設定され、通信の効率性を保つための重要なパラメータです。 デモでは、あるノードがクエリを行う時に、他のノードからランダムにk個が選ばれ、その色(意見)が集計されます。alpha(Quorum Size / α) クエリの結果、多数派と見なすために必要な最小票数です。 あるノードがk個のノードにクエリを送信した結果、返ってきた意見(色)のうちいずれか1つの色がalpha票以上を集めた場合、そのクエリは「成功」と見なされます。 ノードは、この成功した色に自身の支持を更新する可能性があります。 安全性を確保するため、alphaは通常k/2より大きい値に設定されます。
シミュレーション用パラメータ
これらは、デモの動作や見た目を制御するためのパラメータです。 実際のプロトコルそのものに含まれるパラメータではありません。
nodesPerTickシミュレーションの1ティック(時間の最小単位)あたりに、クエリを実行するノードの数です。 この値を大きくすると、より多くのノードが同時に(並列で)クエリを実行する様子をシミュレートでき、合意形成が速く進みます。 実際のネットワークでは、各ノードは非同期で独立してクエリを実行するため、このパラメータはその並列性を擬似的に表現しています。maxInactiveTicksあるノードが連続してクエリを行わなかった場合に、再度クエリを開始するまでの最大ティック数。 これはデモのライブネス(liveness)を維持するための仕組みです。 実際のネットワークでは、ノードは未確定のトランザクションがある限りクエリを続けますが、このデモではランダムに動作を休止させることがあるため、その休止からの復帰タイミングを制御しています。simulationSpeedシミュレーションの進行速度です。 このスライダーを動かすことで、1ティックが進む速さを調整できます。 値を大きくすると、合意形成プロセス全体が速く表示されます。
デモの各四角はノードを示しており、色は各ノードが現在支持している選択肢(トランザクション)を表します。 色の濃さは、その選択肢に対する信頼度(Confidence)または連続成功回数(Conviction)を表します。 色が濃いほど、そのノードはその選択肢が承認されるべきだと強く確信している状態です。
グラフの説明
デフォルトでは上記のように中立な状態になっています。 画面の下にある「Run」ボタンを押すと、青かオレンジのどちらかに収束します。
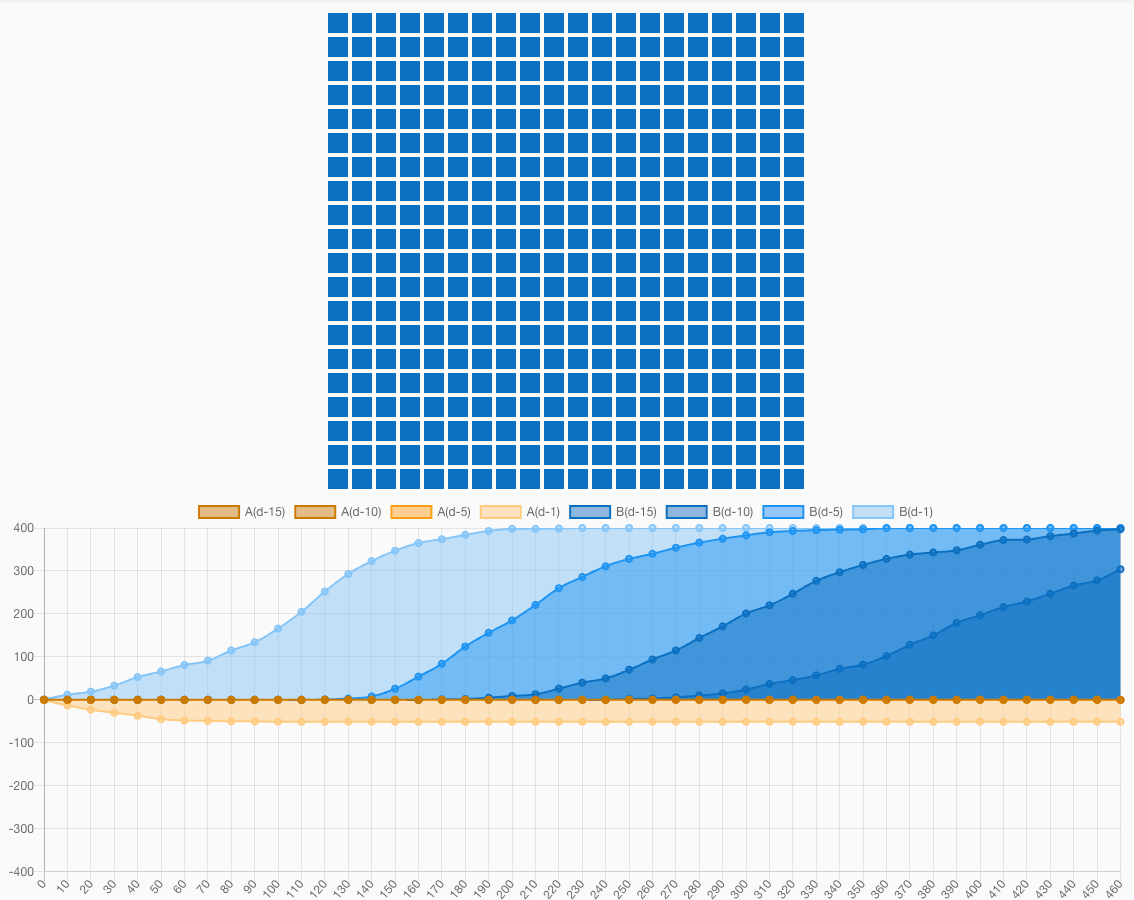
このグラフは、Snowballコンセンサスプロセスのシミュレーション結果を時系列で示しています。 ネットワーク内のノードが、対立する2つの選択肢「A」(オレンジ色)と「B」(青色)の間で、どのように合意を形成していくかを表しています。
このグラフは、最初は意見が拮抗していたネットワークが、ランダムなサンプリングと多数派への追随を繰り返すことで、最終的に選択肢「B」に合意する様子を可視化しています。 最初は両者の支持が僅かですが、一度「B」への支持が優勢になると徐々に全体に波及し、最終的にネットワーク全体が「B」を支持する安定したステートに達しています。
- X軸 (時間)
シミュレーションの経過時間を「ティック」という単位で表しています。
0から460ティックまでの間の変化を示します。 - Y軸 (ノード数)
中央の
0のラインが、意見が完全に分かれている中立状態です。 正の方向(上側)は、選択肢「B」を支持するノードの数を示します。 負の方向(下側)は、選択肢「A」を支持するノードの数を示します。 - 凡例 (色の濃さ)
A(d-X)およびB(d-X)のdは決定(Decision)や深さ(Depth)を意味し、Xの値が小さいほど濃い色で示されます。 これは、Snowflake/Snowballプロトコルにおける連続成功カウンター(consecutiveSuccesses)または信頼カウンター(preferenceStrength)の値の高さを示します。- 色が薄い (
d-1に近い) ノードはその選択肢を支持し始めたばかりで、カウンターの値が低い状態です。 - 色が濃い (
d-15に近い) ノードは何度も連続してその選択肢が多数派であるというクエリ結果を得ており、カウンターの値が高い状態です。 これは、その選択肢に対する支持が固まっていることを意味します。
- 色が薄い (
- 初期状態 (ティック 0 〜 150)
シミュレーション開始直後、ネットワークは中立です。
選択肢「A」(オレンジ)を支持するノードが少数現れますが、その数は増えずに
-50ノード程度で停滞します。 また、色の濃い領域(A(d-10)など)は現れず、Aへの支持が強まることはなかったことがわかります。 一方、選択肢「B」(青)を支持するノードが徐々に増加し始めます。 この段階ではまだ薄い青色(B(d-1))がほとんどで、各ノードの支持はまだ固まっていません。 - 転換点と支持の拡大 (ティック 150 〜 300)
ティック150あたりから、「B」を支持するノードの数が顕著に増加し始めます。
これは、ネットワーク内で「B」を支持するノードの割合がある閾値を超え、その後のランダムサンプリングで「B」が多数派になりやすくなったためです。
この期間に、より濃い青色(
B(d-5),B(d-10))の領域が現れ始めます。 これは、多くのノードが連続して「B」が多数派であるクエリ結果を得て、カウンターの値が増加していることを示します。 - 最終決定へ (ティック 300 〜 460)
「B」への支持はさらに増加し、ネットワークのほぼ全てのノード(400ノード)が「B」を支持するようになります。
最も濃い青色(
B(d-15))の領域も大きく広がり、多くのノードが最終決定(ファイナライズ)に近い、あるいは完了した状態にあることを示唆しています。 一方で、「A」を支持するノードは減少し、ほぼ0になっています。
具体例
デモで示された色の対立と合意形成のプロセスは、実際のAvalancheネットワークで日々発生しているトランザクションやブロックの承認プロセスを抽象化したものです。 ここでは、スマートコントラクトが動作するC-Chainのシナリオに当てはめて説明していきます。
C-ChainはEVM(Ethereum Virtual Machine)互換であり、アカウントベースのモデルを採用しています。 ここでのコンフリクトは、主に同じ親ブロックから分岐した異なるブロック(フォーク)として発生します。
単純なブロックのフォーク(2つの選択肢)
これは、デモで「青 vs オレンジ」として表現されている最も基本的なシナリオです。
2人のブロックプロポーザー(バリデーター)であるアリスとボブが、ほぼ同時に同じ親ブロック(高さN)の子となる新しいブロック(高さN+1)を生成・提案しました。
しかし、それぞれのブロックに含まれるトランザクションの順序や内容が異なっています。
- ブロックA (オレンジ)
プロポーザーはアリス。
[Tx1, Tx2]という順序でトランザクションを含む。 - ブロックB (青)
プロポーザーはボブ。
[Tx2, Tx1]という順序でトランザクションを含む。
これらブロックAとブロックBは、同じ親ブロックから分岐していますが内容が異なるためコンフリクト関係にあります。 ネットワークは、どちらのブロックを正規のチェーンとしてつなげるか、1つだけを選択する必要があります。
-
初期状態 ネットワークの一部のノードは
ブロックAを先に受信してオレンジ色を支持し、別の一部はブロックBを先に受信して青色になります。 デモのグラフでの、Y軸の0ラインを挟んでオレンジと青が混在している状態です。 この時点では、各ノードのカウンターは低い値です。 -
クエリと支持の拡大 各バリデーターは、ランダムに選んだ
k個のノードに「ブロックAとブロックB、どちらを支持するか?」とクエリを投げます。 あるクエリで、偶然ブロックB(青)を支持するノードが多くサンプリングされ、その数がalphaを超えたとします。 クエリを行ったノードは、ブロックBへの信頼カウンター(preferenceStrength)をインクリメントします。 このカウンターはリセットされません。 もしブロックBの信頼カウンターがブロックAの信頼カウンターを上回れば、ノードの支持対象(preference)はブロックBに切り替わります。支持対象が
ブロックBの状態で、今回もブロックBが多数派だったため、連続成功カウンターがインクリメントされます(デモでは青色が濃くなる)。 このカウンターは支持対象が変わるとリセットされます。ブロックAを支持していたノードも、このクエリ結果を見てブロックBに支持を切り替える可能性があります。 このプロセスが繰り返されると、ブロックBを支持するノードの割合が徐々に増加していきます。 デモのグラフで、青色の領域が徐々に拡大していく様子がこれに相当します。 -
最終決定 最終的に、ネットワークの大多数のノードが
ブロックBを支持するようになります。 各ノードでブロックBへの連続成功カウンターがしきい値βに達すると、ブロックBは承認(Accepted)されてファイナリティに達します。 同時に、コンフリクトしていたブロックAは拒否(Rejected)されます。
複雑なフォーク(3つ以上の選択肢)
Snowballプロトコルは、2つだけでなく3つ以上のフォークが発生した場合にも対応できます。
アリスとボブに加えて、キャロルも同じ親ブロック(高さN)から新しいブロックを提案しました。
- ブロックA (オレンジ)
プロポーザーはアリス。
[Tx1, Tx2]を含む。 - ブロックB (青)
プロポーザーはボブ。
[Tx2, Tx1]を含む。 - ブロックC (緑)
プロポーザーはキャロル。
[Tx3]のみを含む。
これら3つのブロックは、同じBlock Heightでコンフリクトしています。
このシナリオをデモで表現すると、オレンジ、青、緑の3色が競合する状態になります。
-
初期状態 ネットワークは、オレンジ、青、緑を支持するノードが混在した状態から始まります。
-
クエリと支持の拡大 各ノードは、これまでと同様にランダムサンプリングによるクエリを実行します。 あるクエリで、
k個のサンプルのうち、ブロックAが3票、ブロックBが6票、ブロックCが1票だったとします。(k=10) もしalpha=5であれば、ブロックBが多数派となります。クエリを行ったノードは、
ブロックB(青)に対する信頼カウンターをインクリメントします。 この結果、ブロックBの信頼カウンターが他のブロックを上回れば、ノードの支持対象はブロックBに切り替わります。 そして、支持対象がブロックBの状態で、今回もブロックBが多数派であったため連続成功カウンターもインクリメントされます。 -
最終決定 このプロセスを繰り返すことで、たとえ最初は3つの選択肢が拮抗していても、ランダムな揺らぎによっていずれか1つのブロックが優勢になります。 そのブロックへの支持が拡大していき、最終的にネットワークはただ1つのブロック(例えば
ブロックB)を承認し、残りのブロックAとブロックCを拒否します。 この最終決定は、各ノードでブロックBに対する連続成功カウンターがβに達した時点で行われます。
このように、SnowmanはSnowballのメカニズムを用いて、C-Chainのようなアカウントベースのチェーンで発生するフォークを解決し、単一の正規なチェーンを決定します。
パラメータの整理
SnowballおよびSnowmanプロトコルは、2種類のカウンターと2つの主要パラメータを用いて、長期的かつ安定した意思決定と短期的で確実な最終決定(ファイナリティ)を両立させています。
| 要素 | 名称 (avalanchego) | 役割 | 特徴 |
|---|---|---|---|
| パラメータ | Alpha (α) |
クエリの成功判定 | k個のサンプルのうち、α票以上を獲得した選択肢があれば、そのクエリは「成功」と見なされる。 |
| パラメータ | Beta (β) |
最終決定の閾値 | 連続成功カウンターがこの値に達すると、その選択肢が最終的に承認(Accept)される。 |
| カウンター | 信頼カウンター (preferenceStrength) |
長期的な支持対象の決定 | 過去のクエリで成功(α票以上を獲得)した回数の累計を各選択肢ごとに記録する。 |
| カウンター | 連続成功カウンター (confidence) |
短期的な最終決定 | 現在支持している選択肢が、連続してクエリで成功した回数を記録する。 |
合意形成は、以下の流れで進みます。
- 毎回のクエリ
ノードは
k個のノードにクエリを送信します。 返ってきた票を集計し、ある選択肢(例:X)がα票以上を獲得したかを確認します。 α達成時の処理 クエリが成功(Xがα票以上を獲得)した場合、まず信頼カウンターを更新します。preferenceStrength[X]をインクリメントします。 このカウンターはリセットされません。 次に、更新された信頼カウンター同士を比較します。 もしpreferenceStrength[X]が他のどの選択肢のカウンターよりも大きくなった場合、ノードの支持対象(preference)をXに設定(または維持)します。 最後に、連続成功カウンターを更新します。 現在の支持対象が、今回の成功した選択肢Xと同じであれば、confidenceをインクリ-メントします。 もし、今回の成功で支持対象が別のものからXに切り替わった場合、confidenceは1にリセットされます。α未達成時の処理 どの選択肢もα票に達しなかった場合、クエリは失敗と見なされます。 信頼カウンターは更新されません。 連続成功カウンターは0にリセットされます。βによる最終決定 ステップ2と3を繰り返す中で、いずれかの選択肢に対する連続成功カウンターの値がβに達した時点で、その選択肢は最終的に承認(Accepted)されてファイナリティに達します。
他コンセンサスとの比較
PoW vs. Snow
ブロックチェーンにおいて、ネットワーク全体の合意を形成するコンセンサスメカニズムは、その性能、セキュリティ、分散性を決定づける最も重要な要素です。 ここでは、ビットコインで採用されているプルーフ・オブ・ワーク(Proof of Work, PoW) を利用したナカモトコンセンサスと、Avalancheで採用されているプルーフ・オブ・ステーク(Proof of Stake, PoS) を利用したSnowコンセンサスを比較し、その違いを詳しく解説します。
PoW/PoSはコンセンサスアルゴリズムではない
まず理解すべき重要な点は、PoWもPoSも、それ自体がコンセンサスアルゴリズムではないということです。 これらは、悪意のある攻撃者が安価に大量のID(アイデンティティ)を生成してネットワークを乗っ取る「シビル攻撃」を防ぐためのシビルコントロールメカニズムです。
- PoW 計算能力(ハッシュパワー)という物理的なリソースをコストとして要求することで、攻撃に経済的なコストを課します。
- PoS ネットワークのネイティブトークン(ステーク)を担保として要求することで、攻撃に経済的なコストを課します。
これらのメカニズムは、合意形成に参加できるノードを制限し、その発言に重み付けを与えるための前提条件です。 実際の合意形成は、これらと組み合わされる別のルール(コンセンサスアルゴリズム)によって行われます。
- ビットコイン(ナカモトコンセンサス) PoW + 最長チェーンルール
- Avalanche PoS + Snowプロトコルファミリー
合意形成のプロセス
ビットコイン (PoW + 最長チェーンルール)
- ブロック生成(マイニング)
マイナーと呼ばれるノードは、ネットワーク上の未確認トランザクションをブロックにまとめます。
次に、「
nonce」と呼ばれる値を様々に変更しながら、ブロック全体のハッシュ値がネットワークで定められた目標値(target)より小さくなるまで膨大な計算を繰り返します。 これがPoWです。 - ブロックの伝播 条件を満たすハッシュ値を最初に見つけたマイナーが、そのブロックをネットワークにブロードキャスト(ゴシップ)します。 他のノードは、そのブロックが正当であることを検証し、自身のチェーンの末尾に追加します。
- コンフリクトの解決 複数のマイナーがほぼ同時にブロックを発見した場合、一時的にチェーンが分岐(フォーク)します。 このコンフリKTは、最も長く、最も多くの計算量(累積PoW)が投入されたチェーンを正当と見なすという「最長チェーンルール」によって解決されます。 短い方のチェーンは破棄され、そこに含まれていたトランザクションは再び未確認状態に戻ります。
PoWについて詳細は以下の記事を読んでください。
Avalanche (PoS + Snowプロトコル)
- ブロック(またはトランザクション)の提案 バリデーターは新しいトランザクションやブロックをネットワークに提案します。
- サブサンプリングによる投票
各バリデーターは、他のバリデーターの中から
k個のノードをステーク量で重み付けしてランダムにサンプリングします。 そして、提案された対象についてどちらを支持するかを問い合わせるクエリを送信します。 - 支持の更新と決定
クエリの結果、
α票以上の多数派が形成された場合、ノードは自身の支持をその多数派の意見に更新します。 このプロセスを繰り返すことで、SnowflakeやSnowballのロジックに基づき、カウンターが蓄積されます。 カウンターがしきい値βに達すると、その対象は承認(Accept)され、ファイナリティに達します。コンフリクトする他の対象は拒否(Reject)されます。
特性の比較
| 特性 | ビットコイン (PoW + 最長チェーン) | Avalanche (PoS + Snow) |
|---|---|---|
| シビルコントロール | プルーフ・オブ・ワーク(PoW) | プルーフ・オブ・ステーク(PoS) |
| エネルギー消費 | 高い。常にマイニング(計算)が必要。トランザクションがない時も停止しない。 | 低い。計算負荷が小さい。トランザクションがない時は静止(Quiescent)する。 |
| コンフリクト解決 | 最長チェーンルール(累積された計算量が最も多いチェーンを選択) | Snowballによる繰り返し投票(ネットワークの支持が多数を占める方を選択) |
| ファイナリティ | 確率的かつ遅い。承認されたブロックが覆る可能性が時間経過とともに指数関数的に減少する。一般的に6ブロック(約60分)で安全と見なされる。 | 確率的かつ速い。承認(Accept)されたトランザクションは、即座に覆ることが確率的に極めて困難になる。通常1〜2秒でファイナリティに達する。 |
| スループット | 低い(約7 TPS)。ブロックサイズとブロック生成間隔によって制限される。 | 高い(数千 TPS)。各ノードの通信量がO(1)であり、並列処理が可能。 |
| リーダーの有無 | 確率的リーダー(PoWを解いたマイナーが一時的なリーダーとなる) | リーダーレス。全てのバリデーターが対等に参加する。 |
| 参加者の匿名性 | 完全な匿名性。 | 参加者はバリデーターである必要があり、ステークによって識別される。 |
| 活性の保証 | ネットワークが分断されると、各パーティションでチェーンが進行するが、グローバルな合意は停止する。 | Virtuous(対立のない)トランザクションについては活性が保証される。Rogue(対立のある)トランザクションは意図的に活性が保証されない場合がある。 |
ナカモトコンセンサスは、PoWによる計算コストと最長チェーンルールを組み合わせることで、オープンでパーミッションレスなネットワークにおける分散合意という画期的な問題を解決しました。 しかし、その代償として、高いエネルギー消費、低いスループット、遅いファイナリティという課題を抱えています。
一方、Snowコンセンサスは、PoSをシビルコントロールとして採用し、サブサンプリングという全く異なるアプローチで合意を形成します。 これにより、エネルギー効率を劇的に改善し、リーダーレスな構造で高い分散性を維持しながら、高速なファイナリティと高いスループットを実現しています。 ただし、その安全性は決定論的ではなく確率的であり、悪意のあるトランザクションに対しては意図的にライブネスを保証しないというトレードオフを受け入れています。 この設計思想の違いが、両者のパフォーマンスと特性の根本的な差異を生み出しています。
Avalanche Goの処理フロー
以下のAvalanche GoのGithubのドキュメントで、Avalancheネットワーク上で単一のブロックチェーンがどのように機能するか、その主要コンポーネントとメッセージの流れがまとめられています。
全体像
graph LR
    A[P2P] --> B[Chain Router]
    B --> C[Handler]
    C --> D[Consensus Engine]
    D --> E[Consensus Logic]
    D --> F[VM]
    D --> G[DB]
    D --> I[Sender]
    F --> G
    I --> A
I --> B上記の図は、外部ネットワーク(P2P)から来たメッセージが、Chain Router → Handler → Consensus Engine へと渡され、処理される流れを示しています。 Consensus Engineは、Consensus Logic(Snowball/Snowmanアルゴリズム)、VM(Virtual Machine)、DB(データベース)と連携してブロックの検証や承認を行い、新たなメッセージを送信する必要が生じた場合はSenderを介して再び外部ネットワークへ送出します。
各コンポーネントの詳細
Avalancheのプライマリーネットワークは、X-Chain, C-Chain, P-Chainという3つのブロックチェーンで構成されています。 これらは全てSnowmanコンセンサスプロトコルを利用しています。
X-ChainはCortinaアップグレード以前はDAGベースのAvalancheコンセンサスを使用していました。
- X-Chain アセットの管理
- C-Chain スマートコントラクトの作成・実行
- P-Chain バリデーターの調整とステーキング
これらのチェーンはバリデーターの集合によって検証されます。 プライマリーネットワークはこれら3つのチェーンを検証する特別なL1です。 ノードには、コンセンサスに参加して報酬を得るバリデーターと、APIとして機能するノンバリデーターの2種類が存在します。
各ブロックチェーンは、VM、データベース、コンセンサスエンジン、Sender、Handlerといった複数のコンポーネントから成り立っています。
P2P (Peer-to-Peer)
ノード間の通信を担う最下層のレイヤーです。
- アウトバウンドメッセージ (
OutboundMsgBuilder) ノードが他のノードへメッセージを送信する時のメッセージビルダーです。 メッセージは以下のカテゴリに分類されます。- Handshake ノードがネットワークに参加するためのバージョン確認。
- State Sync 新規ノードが最新のステートを効率的に同期するためのメッセージ。
- Bootstrapping 新規ノードが過去のブロックをダウンロードし、チェーンをローカルに構築するためのメッセージ。
- Consensus ノードが最新のステートに追いついた後、合意形成のために行うクエリや投票のメッセージ。
- App VMレベルのアプリケーション固有のメッセージ。 代表的な例は、トランザクションをネットワークに拡散させるためのmempool gossipingです。
- ネットワーク層 (
Network)Send(特定ノードへの送信)とGossip(不特定多数への送信)という2つの主要な機能を提供します。 TLSで暗号化された通信路を通じて、ノード間の接続を確立・維持します。
ルーター (ChainRouter)
ChainRouterは、ネットワークから届く全てのメッセージの交通整理を行います。
各メッセージに含まれるChainIDを確認し、それがX-Chain宛なのか、C-Chain宛なのかを判断して、対応するブロックチェーンのHandlerへとメッセージを転送します。
このルーティング機能に加えて、タイムアウト管理も重要な責務です。 Senderが他のノードに応答を要求するメッセージ(クエリなど)を送信する時、ChainRouterに「このリクエストに対するタイムアウトを設定してください」と依頼します。 期間内に応答メッセージがRouterに届けば、Routerはそのタイムアウトを解除します。 もし応答がないまま時間が過ぎるとタイムアウトが発動し、Routerは「応答がありませんでした」という失敗通知をHandlerに送ります。 この仕組みのおかげで、Handlerは個々のピアが応答するかどうかを気にする必要がなく、常に成功か失敗かの結果を受け取ることができます。 さらに、ネットワーク全体の通信が遅延している場合には、タイムアウト時間を自動で長くするなど、状況に応じて設定を調整する機能も備わっています。
ハンドラー (Handler)
Handlerは、ChainRouterから渡されたネットワークメッセージを、コンセンサスエンジンが処理しやすいように整理し、一時的に保持する役割を担います。
メッセージの種類に応じて、2つの異なるキューを使い分けます。 State Sync、Bootstrapping、Consensusといった、処理の順序が重要で、1つ1つの処理が終わるのを待つ必要があるメッセージは同期キュー(Sync Queue) に入れられます。 一方で、Appメッセージ(トランザクションのゴシップなど)のように、他の処理を待たずに非同期で実行できるものは非同期キュー(Async Queue) に入れられます。
Handlerは、これらのキューから順番にメッセージを取り出し、内容を解析した上で、コンセンサスエンジンの適切な処理メソッドを呼び出します。
Sender
Senderは、コンセンサスエンジンからの指示を受けて、他のノードへ送信するアウトバウンドメッセージを構築してネットワーク層へ送る役割を担います。
Senderはネットワーク層の機能をラップしていますが、最も重要な追加機能はタイムアウトの登録です。 クエリのような応答を必要とするメッセージを送信する時には、必ずChainRouterに対してタイムアウトを設定するよう依頼します。 これにより、もし相手ノードから応答がなければ失敗として扱われ、そのノードが繰り返し無応答である場合には、一時的に通信を停止するペナルティ(ベンチリストへの追加)が課される可能性があります。
コンセンサスエンジン (Consensus Engine)
Consensus Engineは、ブロックチェーンの意思決定を行う中心的なコンポーネントです。
新しいブロックを生成する時にはVMにブロックの構築を依頼し、そのブロックを承認するかどうかを決定するために、Snowプロトコル(SnowmanまたはAvalanche)に基づいてネットワークへのポーリング(クエリ)をSenderに指示します。 他のノードからの投票結果を受け取ると、ブロックを承認(Accept)または拒否(Reject)する最終決定を下します。
ブロックチェーンの作成 (Blockchain Creation)
Managerは、ノード起動時に全てのブロックチェーンを初期化し、立ち上げる役割を担います。 まずプライマリーネットワークのP-Chainを起動し、その後にC-ChainやX-Chain、さらにはカスタムサブネットのチェーンを起動します。
また、ノードの稼働中にP-Chain上で新しいブロックチェーンの作成が合意された場合も、Managerがそのトランザクションを検知し、動的に新しいチェーンのコンポーネント群(Handler, Engineなど)を初期化して起動プロセスを開始します。
Frosty
この論文は、Avalancheのブロックチェーンで利用されるSnowmanコンセンサスプロトコルに対し、厳密な安全性の証明と強力なライブネス保証という2つの課題に同時に取り組んでいます。
背景
Snowmanプロトコルは、各ノードが一定の通信量で済むためスケーラビリティに優れていますが、その理論的な基盤には2つの大きな課題がありました。
- 安全性の証明の困難さ Snowmanは確率的なサンプリングに依存するため、その安全性を数学的に証明することは非常に困難な課題とされてきました。 オリジナルのAvalancheホワイトペーパーでは、より単純なSnowballの分析に留まっていました。
- ライブネス攻撃への脆弱性
ネットワーク内のビザンチンノードの割合が一定数(
O(√n))を超えると、合意形成を意図的に遅延させられるライブネス攻撃を受ける可能性がありました。 これは、正直なノードが多数派を形成するのを、ビザンチンノードが妨害し続けることで発生します。
この論文は、ビザンチンノードがf < n/5の環境下で、これら2つの課題を解決する具体的な手法を提案し、その有効性を証明しています。
f < n/5とは、ネットワーク全体のバリデーター総数nのうち、悪意のあるビザンチンノードの数fが5分の1(20%)未満であることを意味します。
提案
Snowflake+による安全性の証明
論文ではまず、安全性の証明という課題に取り組むため、Snowflakeプロトコルの改良版であるSnowflake+ を提案しています。
SnowflakeとSnowflake+の違い
オリジナルのSnowflakeでは、ノードが支持対象を切り替える条件とファイナライズを行う条件の両方に同じ閾値αが使われていました。
Snowflake+ は、これを2つの異なる閾値に分離します。
α1比較的低い閾値(例:過半数を超える程度)。 ノードが自身の支持対象 (preference) を切り替えるために使用されます。α2比較的高い閾値(例:8割以上など)。 ノードが最終決定のためのconfidenceカウンターをインクリメントするために使用されます。
この閾値の分離により、プロトコルの状態遷移がより明確になり、数学的な分析が容易になります。
論文では、このSnowflake+の挙動を確率論(特に二項分布)を用いて詳細に分析し、Snowmanが同期ネットワーク(メッセージ遅延に上限がある理想的なネットワーク)において確率的に安全であることの厳密な証明を初めて提示しました。
Frostyライブネスモジュール
次に、ライブネス攻撃への脆弱性という課題に対処するため、Frostyと呼ばれるモジュールをSnowmanに統合します。
Frostyのコアメカニズム
Frostyは、通常時と攻撃時で異なるプロトコルを使い分けるハイブリッドなアプローチを取ります。 この切り替えはエポックという単位で管理されます。
- 偶数エポック(通常時) ネットワークは高速で通信効率の良いSnowmanで動作します。
- 奇数エポック(攻撃検知時)
ノードが一定期間(
γラウンド)ブロックをファイナライズできない場合、ライブネス攻撃を受けていると判断します。 すると、Epoch Certificate (EC) と呼ばれる証明書を交換してエポックを奇数に切り替えます。 奇数エポックでは、一時的にクオラムベースのプロトコル(この論文ではTendermintを例示)にフォールバックします。 このプロトコルは通信量は多いものの、ビザンチンノードがf < n/3である限り、ブロックの承認を数学的に保証できます。 ここで一定数のブロックを確実に承認した後、再び偶数エポックのSnowmanに戻ります。
Tendermintについては以下の記事を読んでください。
エポック間の安全性保証
異なるプロトコル間を安全に移行するために、Starting Certificate (SC) という仕組みが導入されます。
prefのブロードキャスト 奇数エポックへ移行する時、各ノードは自身の現在のpref(最も支持しているチェーン)をブロードキャストします。- Starting Certificateの形成
全ノードの2/3以上から
prefを集めると、Starting Certificate (SC) が形成されます。 - 安全なチェーンの選択 (
Pref*(C)) SCに含まれるprefの中から、半数以上が支持する最も長い共通のチェーンをPref*(C)として計算します。 - クオラムベースプロトコルの開始
奇数エポックで実行されるプロトコルは、この
Pref*(C)を開始点として動作することが強制されます。
これにより、奇数エポックが過去に承認されたブロックと矛盾するフォークを生成することがなくなり、エポック間の安全性が保証されます。
Error-driven Snowflake+による低レイテンシ化
論文ではさらに、Error-driven Snowflake+ という最適化手法を提案しています。
これは、複数の{α2, β}のペアを同時に監視するものです。
- 高い
α2と低いβのペア ネットワークの状態が良い(ビザンチンノードが少ない)場合、高いα2(例:90%の支持)を達成することは容易です。 その代わり、必要な連続成功回数βを低く設定(例:β=3)することで、非常に低いレイテンシでブロックを承認できます。 - 低い
α2と高いβのペア ネットワークの状態が悪い場合でも、低いα2(例:70%の支持)であれば達成可能です。 その代わり、安全性を確保するためにβは高い値(例:β=12)に設定されます。
この仕組みにより、ネットワークは状況に応じて最適な速度で合意形成を進めることができます。
結論
この論文は、Snowmanに対して初めて厳密な安全性の証明を与え、さらにFrostyモジュールを統合することで強力なライブネス保証を両立させた点で画期的です。
- 安全性
Snowflake+を導入し、f < n/5のビザンチンノードが存在する同期ネットワークにおいて、Snowmanが安全であることを証明しました。 - ライブネス
Frostyモジュールにより、
f < n/3のビザンチンノードによるライブネス攻撃を受けても、チェーンが停止することなく進行し続けることを保証しました。
これにより、Snowmanは理論的な裏付けが大幅に強化され、高速性・スケーラビリティを維持しつつ大規模な攻撃にも耐えうる堅牢なコンセンサスプロトコルであることが示されました。 この研究は、後に部分同期ネットワークへと拡張される「Snowman for partial synchrony」や「Frosty for partial synchrony」の基礎を築く、重要な成果です。
Snowman⋄
この論文では、Snowmanコンセンサスプロトコルをより現実的なネットワーク環境でも安全に動作させるための具体的な改良案、Snowman⋄(スノーマン・ダイヤモンド)を提案しています。
課題
先行研究におけるSnowmanの安全性分析は、以下の2つの仮定に基づいていました。
- 同期ネットワークの仮定 先行研究では、メッセージの遅延には常に事前に定められた上限Δ(デルタ)が存在する同期ネットワークを前提としていました。 これは、タイムアウトを厳密に設定できるため、プロトコルの設計を単純化できるという点で理想的なモデルですが、実際のインターネット環境では常に保証されるわけではありません。
- ロックステップ実行の仮定 全ての正直なノードが、同じタイミングで一斉にサンプリングラウンドを実行するという非現実的な同期を前提としていました。
実際のインターネットではメッセージ遅延は予測不可能であり(非同期性)、各ノードは自身のペースで処理を進めます。 このような環境では、悪意のあるノードがメッセージの配信タイミングを操作することで、正直なノードの意見を意図的に何度も覆して合意形成を妨害する(安全性を脅かす)可能性がありました。
提案手法
この論文は、上記の課題を克服するためにSnowman⋄ を提案しています。 そのコアロジックは、Snowflakeプロトコルを改良したSnowflake⋄ で、新たに導入されたロッキングメカニズムによって非同期期間やロックステップでない実行環境でも安全性を維持します。
2段階の閾値とロッキングメカニズム
Snowflake⋄は、意思決定の確度に応じて2種類の閾値を使い分けることで、柔軟性と安全性を両立させます。
α1(AlphaPreference): 比較的低い閾値(例:過半数を超える程度)です。 ノードが自身の支持対象 (preference) を切り替えるために必要な票数を定義します。α2(AlphaConfidence): 比較的高い閾値(例:8割以上など)です。 ノードが自身の支持対象にロックし、その決定を強固にするために必要な票数を定義します。
ロッキングメカニ-ズムでは、この2段階の閾値を用います。
- ロックの条件
あるノードが、自身の現在の支持対象(例:「赤」)に対して、高い方の閾値
α2以上の票を得た場合、そのノードは「赤」にロックされます。 これは、その選択肢に対するネットワークの支持が強固になったことを意味します。 - アンロックの条件
「赤」にロックされたノードが、対立する選択肢(「青」)に支持を切り替えるには、通常よりも厳しい条件が課されます。
単に「青」が低い方の閾値
α1以上の票を得るだけでは不十分です。 アンロックするためには、「青」が高い方の閾値α2以上の票を獲得し、かつ、その票を投じたノードが「青」に一定期間(論文では2Δ以上)ロックされていたという証拠を提示する必要があります。
この仕組みにより、一度ロックされた状態は、対立する側でも同様に強力で持続的な支持が形成されない限り簡単には覆りません。 これにより、敵対的なメッセージスケジューリングによる攻撃への耐性が大幅に向上します。
安全性の証明
論文では、このロッキングメカニズムによって、部分同期ネットワーク下でも安全性が保たれることを数学的に証明しています。
- 安定したコアの形成 一度、正直なノードの75%以上が同じ選択肢(例:「赤」)にロックされると、その集団は容易に崩れない安定したコアを形成します。
- コアからの離脱の困難性
この状態で、コアに属する正直なノードが「青」にアンロックされるためには、「青」に
2Δ以上ロックされているノードからα2以上の票を得る必要があります。 しかし、正直なノードの75%以上が「赤」にロックされているため、そのような多数派サンプルを形成できる確率は天文学的に低くなります(論文では< 1.18 × 10^-20と計算)。
- 最終的な合意 この結果、一度形成された多数派のロック状態は覆ることがなく、最終的にネットワーク全体がその選択肢に収束することが確率的に保証されます。 この証明は、GST(Global Stabilization Time)以前の非同期期間においても成立するため、部分同期下での安全性が確立されます。
Snowflake⋄からSnowman⋄への拡張
論文では、まずこのロッキングメカニズムを、2つの選択肢(0か1か)の間で合意を形成する単純なプロトコルであるSnowflake⋄ で証明します。
次に、その証明された安全なメカニズムをブロックチェーンという複雑な対象に応用したものがSnowman⋄ です。
Snowman⋄ は、多数の選択肢の中から1つのブロックを選択するという問題を、多数の「2値決定問題」に分解して解決します。 この手法をバイナリ分解(Binary Decomposition) と呼びます。
具体的には、以下のように動作します。
- ブロックハッシュの利用 Snowman⋄ が扱う各ブロックは、一意のハッシュ値(256ビットの数値)を持っています。
- ビットごとのコンフリクト解決
複数のブロックがコンフリクトした場合、Snowman⋄ はそれらのブロックのハッシュ値を先頭から1ビットずつ比較していきます。
- 1ビット目 全てのコンフリクトブロックのハッシュ値の1ビット目が同じであれば、そのビットは確定として次のビットに進みます。
- コンフリクトする最初のビット
例えば、
ブロックAのハッシュのiビット目が0で、ブロックBのハッシュのiビット目が1だったとします。 これが、最初に意見が分かれた点です。 - Snowflake⋄の適用
この
iビット目について、「0と1のどちらを承認するか」という2値決定問題として、安全性が証明されたSnowflake⋄ インスタンスを実行します。
- ブロックの選択 このプロセスを繰り返すことで、最終的にただ1つのハッシュ値が選択されます。 そのハッシュ値を持つブロックが、ネットワークで承認されるべきブロックとなります。
つまり、Snowman⋄ は、ブロックチェーンの合意形成という複雑な問題を、安全なSnowflake⋄ を使って解ける多数の単純な2値決定問題に分解することで全体の安全性を保証しています。 Snowflake⋄ からの変更点は、このバイナリ分解の仕組みを導入した点であり、ロッキングメカニズム自体はSnowflake⋄ のものをそのまま利用しています。
Frosty for partial synchrony
この論文が提案するのは、Snowman⋄ コンセンサスプロトコルに部分同期ネットワーク下で機能する新しいバージョンのFrostyライブネスモジュールを統合する具体的な手法です。 これにより、大規模なビザンチン攻撃下においても、チェーンが停止することなく安全にブロックを承認し続けることが可能になります。
課題
先行研究のFrostyは、ライブネス攻撃を検知するとSnowmanからTendermintのようなクオラムベースのプロトコルに切り替えることでライブネスを保証していました。 しかし、この切り替えプロセスは、メッセージ遅延に常に上限がある同期ネットワークを前提としていました。
部分同期ネットワークでは、メッセージが無限に遅延する非同期期間が存在するため、以下のような問題が発生します。
- 安全性の問題 ネットワークが非同期状態にある間にエポックの切り替えが発生した場合、各ノードが持つ「最後に承認されたブロック」の情報が食い違う可能性があります。 この状態でクオラムベースのプロトコルを開始すると、正直なノードが過去に承認したブロックとは矛盾する、別のフォークを承認してしまう危険性がありました。
- ライブネスの問題 非同期期間が長引くと、ノードがライブネス攻撃を受けていると誤認し、不必要に低速なクオラムベースのプロトコルへ頻繁に切り替えてしまい、パフォーマンスが低下する可能性があります。
提案手法
この論文は、これらの問題を解決するために、Frostyのメカニズムを部分同期ネットワーク向けに改良します。 そのコアロジックは、エポック間の安全性を数学的に保証するための新しいハンドシェイクプロトコルです。
コアメカニズム
Frostyの最も重要な機能は、通常モードの「Snowman⋄」(偶数エポック)から、攻撃時に動作する「Simplex」(奇数エポック)へと安全に移行するための仕組みです。 この安全な移行の鍵となるのが、Starting Certificate (SC) です。
単純にSimplexに切り替えてしまうと、Snowman⋄ で承認されかけていたブロックの情報を無視して、古いブロックから新しいフォークを作ってしまう危険性があります。 これを防ぐため、移行時にネットワーク全体で「どのチェーンを引き継いでSimplexを始めるべきか」について合意する必要があります。
Starting Certificate (SC) による安全な移行プロセス
- 意思表明 (
Starting Vote) ライブネス攻撃によってチェーンの進行が停止したと判断した各ノードは、「私は今、このチェーン(自身のpref)が正しいと思っています」という意思表示(Starting Vote)に署名して、ネットワーク全体に送信します。 - 意思表明の収集と証明書の作成 (
Starting Certificate) 各ノードは、他のノードからのStarting Voteを収集します。 そして、全バリデーターの4/5以上という高い割合の投票が集まった時点で、それらを束ねてStarting Certificate (SC) を作成します。 これは、「ネットワークの大多数が、移行時点での自身の支持チェーンを表明した」という証明書になります。 - 引き継ぐべきチェーンの特定 (
Pref(C)) SCを作成したノードは、集めた多数のpref(各ノードが支持していたチェーン)の中に、半数以上が共通して支持している最も長いチェーンを見つけ出します。 これをPref(C)と呼びます。 Snowman⋄ の安全性により、過去に承認されたブロックは必ずこのPref(C)に含まれることが保証されます。 - Simplexの安全な開始
最後に、奇数エポックで動作を開始するSimplexプロトコルは、この
Pref(C)を自身の最初のブロック(基点)として動作を開始することが義務付けられます。 これにより、Simplexが過去の決定と矛盾するチェーンを生成することがなくなり、安全な移行が完了します。
Simplexプロトコル
Simplexは、クオラムベースのシンプルなビザンチン・フォールト・トレラント(BFT)コンセンサスプロトコルです。 シンプルなプロトコルなので、Frostyのようなより複雑なプロトコルにおいて、ライブネスを保証するためのフォールバックメカニズムとして利用されることに適しています。
ノードメンバーシップとクオラム
プロトコルはn個の静的なノードで構成され、そのうち故障または悪意のあるノード(ビザンチンノード)はf個(n = 3f + 1)と仮定されます。
2つのクオラムが必ず1つ以上の正直なノードを共有するように、クオラムサイズは2f + 1と定義されます。
これにより、ネットワークが二つの意見に完全に分裂することを防ぎます。
プロトコルの流れ
Simplexは、ラウンドという単位で進行し、各ラウンドには決定論的に選出された単一のリーダーが存在します。
-
ブロック提案 ラウンド
iのリーダーは、BlockBuilderインターフェースのBuildBlockメソッドを呼び出し、VMから新しいブロックbを構築します。 このブロックには、コンセンサスプロトコルのステートを示すProtocolMetadataが含まれます。gotype BlockBuilder interface { // BuildBlock blocks until some transactions are available to be batched into a block... BuildBlock(ctx Context, metadata ProtocolMetadata) (Block, bool) // ... } type ProtocolMetadata struct { Version uint8 Epoch uint64 Round uint64 Seq uint64 // a.k.a. block height Prev []byte // digest of the previous block }リーダーはこのブロック
bを他の全ノードにブロードキャストします。 -
ステージ1投票 (Vote) 各ノードは、ラウンド
iでリーダーから最初に受け取ったブロックbを検証します。 有効であれば、そのブロックのハッシュ値H(b)を含んだ投票メッセージ<vote, i, H(b)>を作成し、署名してブロードキャストします。 -
公証 (Notarization) 各ノードは、他のノードからの投票メッセージを収集します。
もし、タイマー
T以内に同じブロックbに対する署名済み投票をクオラム(2f + 1以上)から集めた場合、それらを束ねて公証(Notarization) を形成します。公証とは 「公証」とは、あるブロックがネットワークの多数派(クオラム)によって確認されたことを示す暗号学的な証明です。 一度ブロックが公証されると、正直なノードはそのラウンドでは他のブロックに投票しなくなり、安全性が向上します。 これは、最終的な承認(Finalization)に至るまでの中間的な合意ステップと位置づけられます。
この公証は、ブロック
bがネットワークの多数派に支持されたことを示す証明となります。 このNotarizationは、クラッシュからの復旧に備え、Write-Ahead-Log (WAL)に記録されます。Write-Ahead-Log (WAL)とは WAL(先行書き込みログ)は、システムの耐障害性を確保するための仕組みです。 ノードは、自身のステートを変更する重要なアクション(この場合は「ブロックbを公証済みと認識した」というアクション)を実行する前に、その操作ログをディスクに永続的に書き出します。 これにより、もしノードが不意にクラッシュしても、再起動時にWALを読み込むことでクラッシュ直前のステートを正確に復元し、安全にプロトコルを再開できます。
もし、タイマー
Tが経過してもどのブロックにも十分な票が集まらなかった場合、ノードは空ブロック(Empty Block,⊥)に投票します。 そして、空ブロックに対する投票をクオラムから集め、空の公証(Empty Notarization) をWALに記録します。 -
ステージ2投票 (Finalization) あるブロック
bの公証を受け取ったノードは、そのブロックを最終的に承認するため、<finalize, i, H(b)>という最終決定メッセージを作成し、署名してブロードキャストします。 -
ブロックの承認 (Finalize) あるブロック
bに対して、クオラム(2f + 1以上)からの最終決定メッセージを集めたノードは、それらを最終決定証明書(FinalizationCertificate) としてまとめます。 この証明書をもって、ブロックbは完全に承認されてStorageインターフェースを通じて永続化され、アプリケーション(VM)に渡されます。
https://github.com/ava-labs/Simplex/tree/main#storage-of-blocks-and-protocol-state
type Storage interface {
   // ...
   // Index persists the given block to stable storage and associates it with the given sequence.
   Index(seq uint64, block Block, certificate FinalizationCertificate)
}
ライブネス保証とリソース効率
- タイムアウトと空ブロック リーダーが故障していたり悪意を持っていたりしてブロックを提案しない、あるいはネットワークの分断によって票がクオラムに達しない場合、各ノードはタイムアウトして空ブロックに投票します。 これにより、ラウンドは確実に進行し、次のリーダーへと移ります。 このメカニズムが、プロトコル全体が停止することのないライブネスを保証します。
- 不要なブロック生産の回避
常にブロックを生成するのではなく、VM(アプリケーション層)が
BlockBuilderのWaitForPendingBlockを通じて「保留中のトランザクションがある」とコンセンサス層に通知した場合にのみ、リーダーがブロックを提案するよう最適化されています。 これにより、ネットワークが閑散としている時間帯に、不要な空ブロックが生成され続けることを防ぎ、リソースを節約します。
動的なメンバーシップ変更(再設定)
Simplexは、エポックという概念を導入することで、プロトコルの実行中にバリデーターセットの変更(再設定)に対応します。
- エポック
各ラウンドはエポック番号と関連付けられます。
BlockインターフェースのEndsEpoch()がtrueを返すブロックが承認されると、そのブロックのシーケンス番号(ブロック高)が新しいエポック番号となり、新しいエポックが開始されます。 - 並列インスタンス ノードは、エポックが切り替わる時、古いエポックのSimplexインスタンスをしばらく保持し、まだ追いついていない他のノードからのメッセージに応答し続けます。 同時に、新しいエポックのための新しいSimplexインスタンスを起動します。
- 同期 遅れているノードは、他のノードからEpoch Change Series (ECS) と呼ばれる、エポック変更を引き起こした一連のブロックと証明書を取得することで、最新のバリデーターセットを安全に検証して現在のエポックに追いつくことができます。
この設計により、Simplexは静的なメンバーシップを前提とせず、実際のブロックチェーンのように動的にバリデーターが入れ替わる環境でも安全に動作します。
なぜこの仕組みで安全なのか?
このエポック移行プロセスの安全性の根拠は、「Snowman for partial synchrony」で証明されたSnowman⋄ の特性にあります。
Snowman⋄ では、あるブロックBが正直なノードによって承認されると、その後(次の奇数エポックに移行するまで)正直なノードの3/4以上が、Bを含むチェーンを自身のprefとして保持し続けることが確率的に保証されています。
一方、Starting Certificateを形成するには、全ノードの4/5の投票が必要です。
ビザンチンノードは最大でも1/5未満であるため、この証明書には少なくとも3/5の正直なノードの投票が含まれることになります。
ここで重要なのは、3/4(ブロックBを支持する正直ノードの割合)と3/5(SCに参加する正直ノードの最低割合)を足すと1を超える(3/4 + 3/5 = 27/20 > 1)という点です。
これは、SCに投票した正直なノード群と、ブロックBを支持している正直なノード群には必ず重なりがあることを意味します。
この重なりがあるため、SCに含まれる投票の過半数は、必然的に過去に承認されたブロックBを含むチェーンを支持することになります。
したがって、Pref(C)として計算される「半数以上が支持する最も長い共通チェーン」は、必ず過去に承認された全てのブロックを含んでいることが保証され、エポックをまたいだ安全性が維持されます。
その他の改良点
- Epoch Certificate (EC)
ノードが「停滞している」と判断してエポックの変更を提案するための証明書。
全ノードの1/5以上から
stuckメッセージを集めると形成されます。 - 追加の決定条件
エポック変更の意思決定がスムーズに進むよう、クエリで返される
final(最後に承認したブロック)の情報も利用する新しいファイナリティ条件が追加されます。
結論
この論文は、「Snowman for partial synchrony」で確立された部分同期下での安全性の理論の上に、ライブネスを保証するための具体的なメカニズム(Frosty)を統合する手法を提案しました。
これにより、Snowmanコンセンサスはより強固なプロトコルになりました。
- 通常時(偶数エポック) 高速かつ低コストなSnowman⋄ で動作する。
- 攻撃時(奇数エポック) 安全性を維持したまま、Simplexのようなクオラムベースのプロトコルに移行してライブネスを保証する。
- ネットワーク環境 上記の動作を、現実のインターネット環境に近い部分同期ネットワークで実現する。
Frostyの動作具体例
Frostyがどのようにしてライブネス攻撃からチェーンを回復させるのか、具体例を用いて理解を深めていきます。
前提
- ネットワーク
バリデーター総数
n = 100 - ビザンチンノード
f = 19(論文の仮定f < n/5を満たす) - 正直なノード
81 - プロトコル
- 偶数エポック Snowman⋄
- 奇数エポック Simplex
ステップ1:ライブネス攻撃の発生(偶数エポック)
現在、ネットワークはエポック0で、高速なSnowman⋄ プロトコルで稼働しています。
チェーンはBlock Height 100のブロックBlk_100まで順調に承認されてきました。
しかし、ここで19台のビザンチンノードが結託してライブネス攻撃を開始します。
- 攻撃内容
Block Height 101で正直なノードが提案した
Blk_AとBlk_Bという2つのフォークに対し、ビザンチンノード群は正直なノードを分断するように、あるノードにはBlk_Aと応答して別のノードにはBlk_Bと応答します。 - 結果
正直なノードは、どちらのブロックも
α票の支持を集めることができず、confidenceカウンターがリセットされ続けます。 これにより、新しいブロックが全く承認されない停滞状態に陥ります。
ステップ2:エポック移行の開始
正直なノードは、一定期間(γラウンド)新しいブロックを承認できないと、ライブネス攻撃を受けていると判断します。
- 停滞の検知
正直なノード
V1は、γラウンドの間、最後に承認したブロックがBlk_100のままであることに気づきます。 stuckメッセージの送信V1は、「私はBlk_100で停滞しています」という内容のメッセージ(stuck, epoch=0, final=Blk_100)に署名し、他の全ノードにブロードキャストします。- Epoch Certificate (EC) の形成
他の正直なノードも同様に停滞を検知して
stuckメッセージを送信します。 あるノードが、異なるノードからのstuckメッセージをn/5 = 20通以上集めると、Epoch Certificate (EC) が形成されます。 これにより、エポック1への移行が正式にトリガーされます。
ステップ3:安全なチェーンの特定(エポック1へのハンドシェイク)
エポック1に移行した各ノードは、Simplexプロトコルを安全に開始するために、まずStarting Certificate (SC) を形成します。
prefのブロードキャスト 正直なノードの多くは、攻撃によってBlk_AかBlk_Bのどちらかを暫定的に支持(pref)していますが、まだどちらも承認(final)はしていません。 各ノードは、自身の現在のpref(例:V1はBlk_Aまでのチェーン)を含む(start, epoch=1, pref=...Blk_A)というメッセージに署名し、ブロードキャストします。- Starting Certificateの形成と
Pref(C)の計算 あるノードが、4n/5 = 80通以上のstartメッセージを集め、Starting Certificate (SC) を形成します。 このSCには、Blk_Aを支持する投票とBlk_Bを支持する投票が混在していますが、両者に共通する最も長いチェーンは攻撃が始まる前のBlk_100です。 そのため、SCに含まれる投票の半数以上が支持する最も長い共通チェーンPref(C)は、Blk_100までのチェーンとなります。
ステップ4:Simplexによるブロック承認(奇数エポック)
これで、エポック1で実行されるSimplexプロトコルの準備が整いました。
- Simplexの開始
Simplexプロトコルは、
Pref(C)、つまりBlk_100を基点として開始されます。 - リーダーによるブロック提案
Simplexのルールに従って、Block Height 101のブロックを提案するリーダー(例:
V2)が決定論的に選出されます。V2は、Blk_100の子として、新しいブロックBlk_Sを提案します。 このブロックには、停滞期間中に溜まっていた未確認トランザクションが含まれます。 - クオラム投票と承認
Simplexはクオラムベースであるため、
f < n/5という条件下では、ビザンチンノードはブロックの承認を妨害できません。 正直なノードはBlk_Sに投票し、4/5以上の票が集まることでBlk_Sは承認されます。 このプロセスを、規定の数のブロック(例:μ個)が承認されるまで繰り返します。
ステップ5:通常モードへの復帰
Simplexによってチェーンが進んでライブネスが回復した後、ネットワークは再び高速なSnowman⋄に戻ります。
- エポック2への移行 規定数のブロックが承認されると、自動的にエポック2に移行し、再びSnowman⋄ プロトコルでの運用が開始されます。
このようにして、Frostyはライブネス攻撃を検知して一時的に堅牢なプロトコルに切り替えることでチェーンの停滞を解消し、安全性を維持したまま通常運用へと復帰します。
悪意のあるリーダーへの対策
Simplexのリーダーが悪意を持っていた場合、以下のような妨害行為を行う可能性があります。
- ブロックを提案しない 自身の番になっても意図的にブロックを提案せず、チェーンの進行を遅らせようとする。
- 不正なブロックを提案する 無効なトランザクションを含むブロックや、過去の承認済みブロックと矛盾するブロックを提案する。
Simplexは、これらの攻撃に次のように対処します。
ブロックを提案しない攻撃への対策(タイムアウト)
各ラウンド(ビュー)には、リーダーがブロックを提案するための制限時間が設けられています。 もしリーダーがこの時間内に有効なブロックを提案しなかった場合、他のバリデーターはそのラウンドがタイムアウトしたと判断します。 タイムアウト後、そのラウンドではダミーブロック(空のブロック) が承認され、次のラウンドに進みます。 そして、リーダーは次のバリデーターに交代します。
これにより、一人の悪意のあるリーダーがチェーンを永続的に停止させることはできません。 チェーンは(空のブロックを挟みながらも)進行し続け、いずれ正直なリーダーの番が回ってくることで有効なトランザクションを含むブロックが承認されます。
不正なブロックを提案する攻撃への対策(投票による拒否)
リーダーが悪意を持って不正なブロックを提案しても、正直なバリデーターはそのブロックを検証して無効であると判断します。 正直なバリデーターは、無効なブロックに対しては投票しません。 結果として、その不正なブロックは承認に必要なクオラム(4/5以上) の票を集めることができず、承認されません。 この場合も、最終的にはタイムアウト機構が働き、そのラウンドは失敗(またはダミーブロックの承認)となって次のリーダーへと移ります。
References
- https://build.avax.network/docs/quick-start/avalanche-consensus
- https://cdn.prod.website-files.com/5d80307810123f5ffbb34d6e/6009805681b416f34dcae012_Avalanche%20Consensus%20Whitepaper.pdf
- https://github.com/ava-labs/avalanchego
- https://tedyin.com/archive/snow-bft-demo
- https://github.com/ava-labs/avalanchego/blob/master/snow/README.md
- https://crypto.unibe.ch/talks/20250605-consensus+avalanche-web.pdf
- https://github.com/ava-labs/avalanchego/blob/master/vms/proposervm/README.md
- https://gyuho.dev/consensus-systems/nakamoto-bitcoin-vs-snow-avalanche/
最後に
今回はAvalancheのコンセスメカニズムについてまとめてきました。
他でも色々記事を書いているのでぜひよろしければ読んでいってください!