はじめに
初めまして。 『DApps開発入門』という本や色々記事を書いているかるでねです。
以下でも情報発信しているので、興味ある記事があればぜひ読んでみてください!



今回は、EVMのスタック操作命令(SWAP*/DUP*)が抱えるスタック深度16段の制限を、後方互換性を保ちながら突破する3つの新命令を提案しているEIP8024についてまとめていきます!
以下にまとめられているものを解説しながらまとめていきます。

他にも様々なEIP・BIP・SLIP・CAIP・ENSIP・RFC・ACPについてまとめています。
概要
EIP8024とは、EVMにDUPN、SWAPN、EXCHANGEという3つの新しいスタック操作命令を追加する提案です。
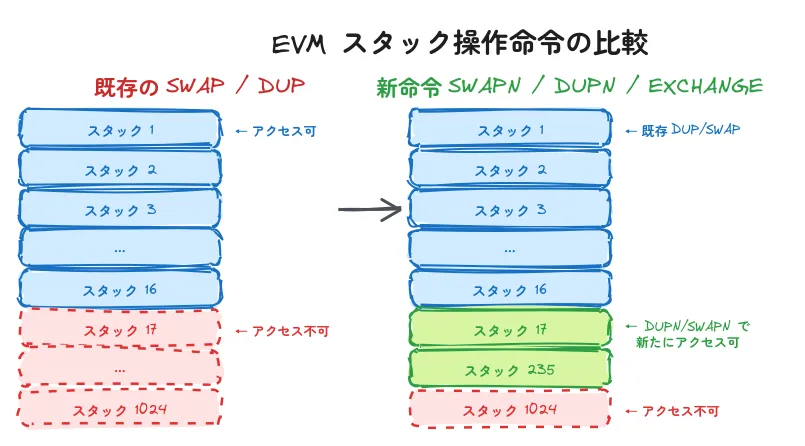
現在のEVMでは、DUP1〜DUP16およびSWAP1〜SWAP16という命令が用意されていますが、どちらもスタックの上位16段までしかアクセスできません。
EVMのスタック自体は最大1024段の深さを持っているにもかかわらず、簡単にアクセスできるのはたったの16段です。
この制約はSolidityでおなじみの「stack too deep」エラーの原因でもあり、コンパイラに複雑な回避策を強いてきました。
EIP8024はこの長年の制限を解消するために、スタックの最大235段目までアクセスできる新命令を導入します。 しかも、既存のコントラクトの動作やジャンプターゲットに一切影響を与えない、完全に後方互換な設計になっています。
以下の図は、既存のSWAP/DUP命令と新命令のアクセス可能範囲の違いを示しています。
EIP663との関係
この提案は、もともとEOF(EVM Object Format)の一部として提案されていたEIP663をベースにしています。
EIP663は同じSWAPN/DUPN/EXCHANGE命令を定義していますが、EOFというバイトコードフォーマットの変更に依存しているため、EOFが導入されるまで使えません。
EIP8024はEOFへの依存を排除し、現行のEVMバイトコードにそのまま追加できるように再設計されています。
具体的には、EIP663では即値オペランドに任意のバイト値を使えますが、EIP8024ではJUMPDEST(0x5b)やPUSH命令(0x60〜0x7f)と衝突するバイト値を禁止するエンコーディングを採用しています。
これにより、既存のJUMPDEST解析を一切変更せずに新命令を導入できます。
| 項目 | EIP663 | EIP8024 |
|---|---|---|
| EOF依存 | あり | なし |
| 即値の禁止範囲 | なし | 0x5b〜0x7f |
| JUMPDEST解析の変更 | 必要 | 不要 |
| 導入条件 | EOFの導入が前提 | 単独で導入可能 |
動機
スタック16段制限によるコンパイラの複雑化
EVMのスタックは1024段の深さを持っていますが、DUP*/SWAP*命令で直接アクセスできるのは上位16段だけです。
そのため、17段目以降のスタック要素にアクセスしたい場合、コンパイラはその値をメモリに退避するか、スタック上の配置を工夫して16段以内に収まるように調整する必要があります。
この「stack to memory elevation」と呼ばれる手法は、コンパイラの出力を複雑にし、ガス効率も悪化させます。
本来はスタック上で完結できる処理であっても、MSTORE/MLOADを使ってメモリ経由のアクセスを行うことになるためです。
関数呼び出し時の引数・戻り値の制約
EVM上で高レベルな言語構造(関数呼び出しなど)を実装する場合、スタックには入力パラメータ、出力パラメータ、リターンアドレスなどが積まれます。 これらのスタック項目の数は容易に16を超えることがあり、コンパイラはすべての項目がアクセス可能な範囲に収まるように配置を慎重に管理しなければなりません。
Solidityでは、ローカル変数や関数の引数が多くなると「Stack too deep, try removing local variables」というコンパイルエラーが発生します。 これは開発者にとって大きなフラストレーションの原因であり、コードの構造を本来必要のない形に変更せざるを得ない状況を生み出してきました。
スタックスケジューリングの最適化
コンパイラの最適化技術の一つに、スタックスケジューリングアルゴリズムがあります。 これは、レジスタマシンにおけるレジスタ割り当ての、スタックマシン版に相当するものです。 変数の使用パターンを分析し、スタック上の移動(トラフィック)を最小化するように命令の順序を最適化します。
しかし、現在のEVMではスタックの1番目とN番目の要素を入れ替えるSWAPしかありません。
たとえば3番目と5番目の要素を入れ替えたい場合、SWAP2 SWAP4 SWAP2のように3つの命令が必要です。
EVM実装の内部では、これらの操作はいずれも単なるポインタの入れ替えにすぎないため、1命令で実行できるはずのものを3命令に分けるのは非効率です。
EIP8024のEXCHANGE命令はまさにこの問題を解決し、任意の2つのスタック要素を1命令で入れ替えられるようにします。
仕様
以下の図は、3つの新命令がスタック要素をどのように操作するかを示しています。
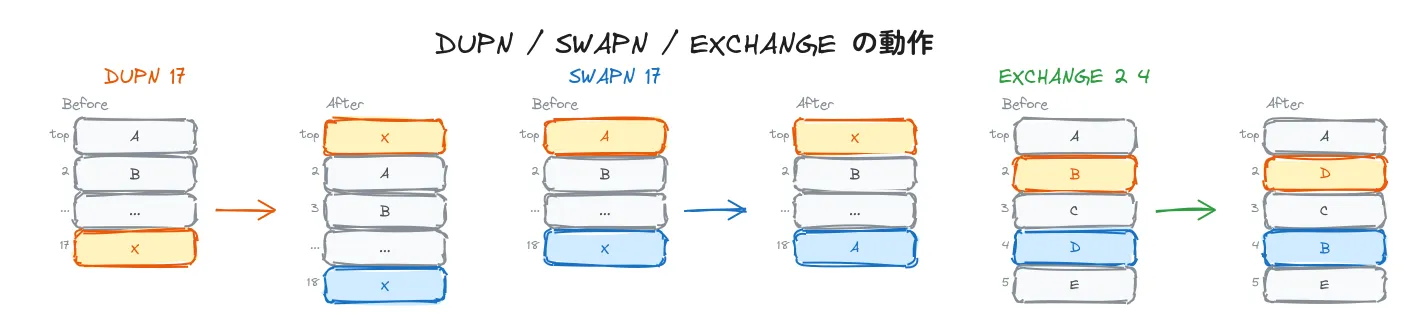
EIP8024では以下の3つの新命令を導入します。
| 命令 | オペコード | 機能 |
|---|---|---|
DUPN |
0xe6 |
スタックのn番目の要素をスタックトップに複製する |
SWAPN |
0xe7 |
スタックのn+1番目の要素とスタックトップを入れ替える |
EXCHANGE |
0xe8 |
スタックのn+1番目とm+1番目の要素を入れ替える |
各命令はオペコードの直後に1バイトの即値オペランドを持ちます。 この即値をデコードして、操作対象のスタック位置を決定します。
DUPN命令
DUPNは、スタックのn番目の要素をスタックトップに複製します。
既存のDUP1〜DUP16がスタックの1〜16番目にしかアクセスできないのに対し、DUPNは17〜235番目の要素にアクセスできます。
// DUPN の実行フロー(擬似コード)
// 1. ガス3を消費
// 2. 即値 x = code[pc + 1] を読み取る
// 3. x が禁止範囲(91〜127)の場合、異常終了
// 4. n = decode_single(x) でスタック位置を算出
// 5. n > スタックの長さ の場合、異常終了
// 6. stack[top - n + 1] をスタックトップにプッシュ
// 7. pc = pc + 2 に進めるガスコストは既存のDUP*命令と同じ3です。
内部的にはポインタ操作でスタック要素を参照するだけなので、スタックのどの深さにアクセスしても計算コストは変わりません。
SWAPN命令
SWAPNは、スタックのn+1番目の要素とスタックトップの要素を入れ替えます。
既存のSWAP1〜SWAP16の拡張版で、18〜236番目の要素とスタックトップの交換が可能です。
// SWAPN の実行フロー(擬似コード)
// 1. ガス3を消費
// 2. 即値 x = code[pc + 1] を読み取る
// 3. x が禁止範囲(91〜127)の場合、異常終了
// 4. n = decode_single(x) でスタック位置を算出
// 5. n + 1 > スタックの長さ の場合、異常終了
// 6. stack[top - n] と stack[top] を入れ替え
// 7. pc = pc + 2 に進めるSWAPNの「n+1番目」という表現は、既存のSWAP命令との整合性を保つためです。
SWAP1はスタックの2番目(1+1番目)とトップを入れ替えるため、SWAPN 1も同じく2番目とトップを入れ替えます。
EXCHANGE命令
EXCHANGEは、スタックトップを介さずに、任意の2つのスタック要素を直接入れ替えます。
この命令はDUPNやSWAPNとは異なり、2つのスタック位置(n+1番目とm+1番目)を指定します。
// EXCHANGE の実行フロー(擬似コード)
// 1. ガス3を消費
// 2. 即値 x = code[pc + 1] を読み取る
// 3. x が禁止範囲(82〜127)の場合、異常終了
// 4. (n, m) = decode_pair(x) でスタック位置を算出
// 5. m + 1 > スタックの長さ の場合、異常終了
// 6. stack[top - n] と stack[top - m] を入れ替え
// 7. pc = pc + 2 に進めるEXCHANGEのオペランドはSWAP/SWAPNと一貫した「オフバイワン」の表現を使用しています。
つまり、EXCHANGE n mはSWAP{n} SWAP{m} SWAP{n}と同じ効果を1命令で実現します。
たとえば、スタックの3番目と5番目の要素を入れ替えるEXCHANGE 2 4の動作を見てみましょう。
スタックが上から[a, b, c, d, e, ...]の時、SWAP2 SWAP4 SWAP2の3命令を使うと以下のようになります。
SWAP2(1番目と3番目を交換) →[c, b, a, d, e, ...]SWAP4(1番目と5番目を交換) →[e, b, a, d, c, ...]SWAP2(1番目と3番目を交換) →[a, b, e, d, c, ...]
結果として3番目と5番目だけが入れ替わっています。
EXCHANGE 2 4はこの3命令の効果を1命令で実現します。
EVM実装の内部ではどちらもポインタの入れ替えにすぎないため、ガスコストを3分の1にできるわけです。
エンコーディング
3つの命令はいずれも1バイトの即値オペランドを使いますが、そのデコード方法が特殊です。
これは後方互換性を確保するために、特定のバイト値(0x5b〜0x7f)を即値として使用しないようにするためです。
decode_single関数
DUPNとSWAPNはdecode_single関数を使って即値をデコードします。
def decode_single(x: int) -> int:
    """17 <= n <= 235 の範囲の値を返す"""
    assert 0 <= x <= 90 or 128 <= x <= 255
return (x + 145) % 256入力値xの有効範囲は0〜90および128〜255で、91〜127は禁止されています。
この関数はxに145を加えて256で剰余を取ることで、17〜235の範囲のスタック位置に変換します。
エンコード(コンパイラ側)は以下の逆関数で行います。
def encode_single(n: int) -> int:
    assert 17 <= n <= 235
return (n + 111) % 256なぜ17からスタートするかというと、1〜16番目のスタック要素には既存のDUP1〜DUP16/SWAP1〜SWAP16でアクセスできるため、DUPN/SWAPNがカバーする必要がないためです。
decode_pair関数
EXCHANGEは1バイトの即値から2つのスタック位置(n, m)を復元する必要があるため、より複雑なデコードを行います。
def decode_pair(x: int) -> tuple[int, int]:
    """(n, m) を返す(1 <= n <= 14, n < m <= 30 - n)"""
    assert 0 <= x <= 81 or 128 <= x <= 255
    k = x ^ 143
    q, r = divmod(k, 16)
    if q < r:
        return q + 1, r + 1
    else:
return r + 1, 29 - qこの関数は1バイトの即値からnとmのペアを復元します。 nの範囲は1〜14、mはnより大きく30-n以下です。 つまり、スタックの2番目から最大30番目までの要素を対象にした交換が可能です。
エンコード(コンパイラ側)は以下の関数で行います。
def encode_pair(n: int, m: int) -> int:
    assert 1 <= n < m and n + m <= 30
    if m <= 16:
        q, r = n - 1, m - 1
    else:
        q, r = 29 - m, n - 1
    k = 16 * q + r
return k ^ 143エンコーディングの設計方針
decode_pair関数の設計には、いくつかのトレードオフが反映されています。
以前のEXCHANGEの定式化では、一定の距離内にあるスタック要素同士の交換のみを許可していました。
その結果、インデックス30と29の交換はできるものの、インデックス30の要素を2の位置に1命令で移動することはできませんでした。
現在の定式化では、スタックのトップに近い位置への要素移動を優先しています。
スタック深部の要素を並べ替えるよりも、深い位置から浅い位置への移動の方がコンパイラにとって有用だからです。
また、decode_pair関数は基本的な算術演算、ビット演算、最小限の分岐で実装できるように設計されています。
アドレス可能なペア数をわずかに犠牲にすることで、デコード処理の複雑さを抑えています。
禁止即値範囲
各命令で禁止される即値の範囲は以下の通りです。
| 命令 | 禁止範囲 | 有効範囲 |
|---|---|---|
DUPN |
91〜127 | 0〜90, 128〜255 |
SWAPN |
91〜127 | 0〜90, 128〜255 |
EXCHANGE |
82〜127 | 0〜81, 128〜255 |
禁止範囲には0x5b(JUMPDEST、10進数91)と0x60〜0x7f(PUSH1〜PUSH32、10進数96〜127)が含まれています。
禁止即値がコードに出現した場合、その命令は即座に異常終了(exceptional halt)します。
ディスアセンブラは、この場合のオペコードをINVALID(またはINVALID_DUPN等)としてデコードし、後続のバイトを通常通り解釈します。
JUMPDEST解析との関係
EVMには「命令の途中にジャンプできない」という重要な性質があります。
PUSH1〜PUSH32命令の即値(オペランド)部分に0x5b(JUMPDESTのオペコード)が含まれていても、それは有効なジャンプターゲットとはみなされません。
これはJUMPDEST解析というプロセスで保証されています。
EIP8024はこのJUMPDEST解析を一切変更しません。
代わりに、新命令の即値に0x5bを含むバイト値を禁止することで、同じ安全性を実現しています。
以下の具体例で、なぜこの設計が必要かを見てみましょう。
バイト列e6 5bを考えます。
EIP8024導入前は、e6は未定義のオペコード(INVALID)で、5bはJUMPDESTとして解釈されます。
もしJUMPDEST解析を変更してe6の次のバイトをマスク(無視)するように変更した場合、5bはもはや有効なジャンプターゲットではなくなります。
これは既存のコントラクトの動作を壊す可能性があります。
逆のケースもあります。
バイト列e6 60 5bは、導入前はINVALID PUSH1 0x5bと解釈され、5bはPUSH1の即値なのでジャンプターゲットではありません。
しかしJUMPDEST解析を変更した場合、DUPN 0x60 JUMPDESTと解釈され、5bが新たなジャンプターゲットになってしまう可能性があります。
EIP8024の設計では、0x5bを含む即値は禁止されているため、e6 5bはINVALID_DUPN JUMPDESTとしてデコードされます。
5bは依然として有効なジャンプターゲットのままであり、既存コントラクトの動作に影響しません。
以下のフロー図は、バイト列の解釈がどのように変わるか(変わらないか)を示しています。
flowchart TD
    A["バイト列: e6 5b"] --> B{"EIP8024導入前"}
    A --> C{"EIP8024導入後"}
    B --> D["INVALID + JUMPDEST\n(5bはジャンプ可能)"]
    C --> E["INVALID_DUPN + JUMPDEST\n(5bはジャンプ可能)"]
    D --> F["動作は同じ ✅"]
E --> Fコード末尾の挙動
code[pc + 1]がコードの末尾を超えている場合、値は0として評価されます。
これはPUSH命令の既存の動作と一致しています。
補足
即値オペランドを使う理由
DUPN/SWAPN/EXCHANGEの操作対象をスタックから動的に取得する方法(DUPのようにスタックトップの値をインデックスとして使う方法)も考えられましたが、採用されていません。
動的な引数を許可すると、スタックの内容を実行前に静的に分析することが困難になります。 セキュリティ監査者にとって静的解析は重要なツールであり、スタック操作のパターンを静的に把握できることは安全性の確保に大きく貢献します。 そのため、操作対象はコード中に直接埋め込まれた即値(イミディエート)として指定し、動的には変更できない設計が選ばれています。
即値サイズの検討
DUPNとSWAPNの即値を2バイトにすればスタック全体(1024段)をカバーできますが、以下の理由で1バイトに抑えられています。
まず、2バイトにすると追加の制約チェック(n < 1024)が必要になります。
そして、現在の16段から235段への拡張は十分に大きな改善であり、2バイト目の追加によるコードサイズの増加に見合いません。
同様に、EXCHANGE命令が1バイトでアドレスできるペア数は有限ですが、スタックの最大30番目までをカバーしており、実用上は十分です。
禁止即値範囲の将来的な再利用
EIP8024のエンコーディングは、今後追加される即値付き命令でも再利用できます。
ただし、新命令のオペランド範囲が自然に0x5b(JUMPDEST)や0x60〜0x7f(PUSH1〜PUSH32)を含まない場合は、マスク処理自体が不要です。
また、EXCHANGE命令ではdecode_pairのデコード複雑度を抑えるために、アドレス可能なペアの一部を犠牲にしています。
この未割り当て範囲は、将来のネットワークアップグレードでデコード処理を複雑化する代わりに、十数個の追加ペアに割り当てることも可能です。
ガスコストの根拠
新命令のガスコストは既存のDUP*/SWAP*と同じ3に設定されています。
これは、EVM実装の内部ではスタック操作がポインタの入れ替えで実装されており、スタック深度に関係なく同じ計算コストだからです。
即値のデコード処理は単純な算術演算であり、追加のコストは無視できる程度です。
EXCHANGEがSWAPNとは別に必要な理由
前述の通り、スタックの1番目以外の2つの要素を入れ替えるには、SWAPを3回使う必要があります。
具体的には、スタックの3番目を2番目に移動したい場合、SWAP2 SWAP3 SWAP2という3命令が必要です。
しかし、EVM実装の内部ではこの操作は単なるポインタの入れ替えであり、1命令で実行してもクライアントの実行コストは変わりません。
EXCHANGE命令はコンパイラのスタックスケジューリングアルゴリズムにとって特に重要です。
スタックの深い位置にある変数を消費位置に移動するために必要な命令数を3分の1に削減でき、コードサイズとガスの両方を節約できます。
後方互換性
EIP8024は、既存のコントラクトに対して影響を与えないように慎重に設計されています。
この提案が保証する後方互換性は以下の通りです。
あるバイト列上で、未定義のオペコードを実行しようとしない限り、すべての実行トレースはEIP8024導入後も同じ結果を生み出します。
新命令の導入によって、既存のバイト列に新しいJUMPDESTが生まれることも、既存のJUMPDESTが消えることもありません。
EVMには専用のデータセクションがないため、任意のバイト列がコード中に埋め込まれている可能性があります(CODECOPYで不変データとしてアクセスするケースなど)。
そのため、デプロイ済みまたは未発行のトランザクションに含まれるあらゆるバイト列について、後方互換性を保証する必要があります。
EIP8024のエンコーディング設計はこの要件を満たしています。
テストケース
アセンブリ・逆アセンブリの例
以下は、バイト列がどのようにデコードされるかの例です。
| バイト列 | デコード結果 | 説明 |
|---|---|---|
e680 |
DUPN 17 |
最小のDUPN。スタックの17番目を複製する |
e7db |
SWAPN 108 |
スタックの109番目とトップを入れ替える |
e6805b |
DUPN 17, JUMPDEST |
DUPNの後に有効なJUMPDEST |
e75b |
INVALID_SWAPN, JUMPDEST |
即値0x5bは禁止。JUMPDESTはそのまま有効 |
e6605b |
INVALID_DUPN, PUSH1 0x5b |
即値0x60は禁止。PUSH1として解釈が継続 |
e7610000 |
INVALID_SWAPN, PUSH2 0x0000 |
即値0x61は禁止。PUSH2として解釈が継続 |
e65f |
INVALID_DUPN, PUSH0 |
即値0x5fは禁止。PUSH0として解釈が継続 |
e89d |
EXCHANGE 2 3 |
スタックの3番目と4番目を入れ替える |
e82f |
EXCHANGE 1 19 |
スタックの2番目と20番目を入れ替える |
e850 |
EXCHANGE 14 16 |
スタックの15番目と17番目を入れ替える |
e851 |
EXCHANGE 14 15 |
スタックの15番目と16番目を入れ替える |
e852 |
INVALID_EXCHANGE, MSTORE |
即値0x52は禁止。MSTOREとして解釈が継続 |
実行例
以下の実行例では、各命令の動作を具体的に確認できます。
DUPNの動作確認
バイト列 60016000808080808080808080808080808080e680 を実行すると、スタックに18個の要素が積まれます。
スタックトップの値は1、スタック最下部の値も1、その間の16個の値はすべて0です。
DUPN 17がスタックの17番目(最下部の要素、値は1)を複製してトップに配置した結果です。
SWAPNの動作確認
バイト列 600160008080808080808080808080808080806002e780 を実行すると、スタックに18個の要素が積まれます。
スタックトップの値は1、最下部の値は2です。
SWAPN 17がスタックの18番目(最下部、値は2)とトップ(値は1)を入れ替えた結果です。
EXCHANGEの動作確認
バイト列 600060016002e88e を実行すると、スタックに3個の要素が積まれます。
上から順に[2, 0, 1]です。
EXCHANGE 1 2がスタックの2番目(値1)と3番目(値0)を入れ替えた結果です。
EXCHANGEの追加動作確認
バイト列 600260008080808080600160008080808080808080e8 を実行すると、最終的にスタックに17個の要素が積まれます。
スタック最下部の値は1、上から10番目の値は2、残りは0です。
コード末尾のe8は次のバイトが存在しないため即値が0として評価され、EXCHANGEが実行されます。
バイト列 600080808080808080808080808080808080808080808080808080808060016002e88f を実行すると、スタックに30個の要素が積まれます。
スタックトップの値は2、最下部の値は1、残りは0です。
EXCHANGE 1 29がスタックの2番目(値1)と30番目(値0)の要素を入れ替えた例です。
バイト列 60008080e88e15 を実行すると、スタックに3個の要素が積まれ、トップの値は1です。
EXCHANGE 1 2で2番目と3番目を入れ替えた後、ISZERO(0x15)がスタックトップの値(0)を1に変換しています。
エラーケース
バイト列e75bを実行すると、即値0x5bが禁止範囲に含まれるため、異常終了(revert)します。
同様に、バイト列e852も即値0x52がEXCHANGEの禁止範囲(82〜127)に含まれるため、異常終了します。
バイト列6000808080808080808080808080808080e680を実行すると、スタックに16個しか要素がない状態でDUPN 17を実行しようとするため、スタック不足で異常終了します。
一方、バイト列600456e65bは正常に実行されます。
PUSH1 04で4をスタックに積み、JUMPでオフセット4にジャンプします。
オフセット3のe6はINVALID_DUPNですが実行されず、オフセット4の5bは有効なJUMPDESTとして機能します。
セキュリティ
EIP8024の著者は、この提案によって追加されるセキュリティリスクは認識していないとしています。
EVMのスタックは1024段に固定されており、ほとんどの実装でスタック全体が常にメモリ上に保持されています。 この提案は単一の命令でアクセスできるスタック要素の範囲を拡大するだけであり、スタックサイズ自体を変更するものではありません。
新命令がアクセスできるスタック要素は既存の範囲内にあり、従来のDUP*/SWAP*で複数命令を使ってアクセスできていたものを、1命令でアクセスできるようにしたにすぎません。
そのため、新しい攻撃ベクトルが生まれる可能性は低いと考えられます。
引用
最後に
今回は「EIP8024によるEVMスタック操作の16段制限突破」についてまとめてきました! いかがだったでしょうか?
EVMのDUP*/SWAP*命令がスタック上位16段にしかアクセスできない制約は、Solidityの「stack too deep」エラーとしてEthereum開発者の多くが経験してきた問題です。
EIP8024は、EOFに依存せずに後方互換性を完全に保ちながらこの制限を解消する、シンプルかつ強力な提案です。
特にEXCHANGE命令はコンパイラの最適化に大きく貢献し、コードサイズとガスコストの両方を削減できます。
質問などがある方は以下のTwitterのDMなどからお気軽に質問してください!
他の媒体でも情報発信しているのでぜひ他も見ていってください!