はじめに
初めまして。 『DApps開発入門』という本や色々記事を書いているかるでねです。
以下でも情報発信しているので、興味ある記事があればぜひ読んでみてください!


AIコーディングエージェントへ「商品検索APIに価格帯フィルターを追加して」と頼むだけでは、要求と実装方法が同じ会話に混ざります。 金額の下限だけを指定できるのか、価格帯の境界値を検索結果へ含めるのか、下限が上限を超えた時に何を返すのかが決まっていなくても、エージェントは何らかのコードを書けます。 そのコードが依頼どおりか確認するには、実装前に要求を分け、実装後に同じ要求へ戻れる記録が要ります。
GitHub Spec Kitは、プロジェクト共通の原則と機能ごとの記録を分け、AIコーディングエージェントが要求から実装までを順に処理するためのツールです。 商品検索APIへ価格帯フィルターを追加する例を使い、各ファイルの役割から既存プロジェクトでの使い方までを説明します。
GitHub Spec Kitとは
GitHub Spec Kitは、要求、技術設計、作業一覧を別々の記録へ保存し、実装後にコードとの不足を確認する工程をAIコーディングエージェントへ提供するツールです。
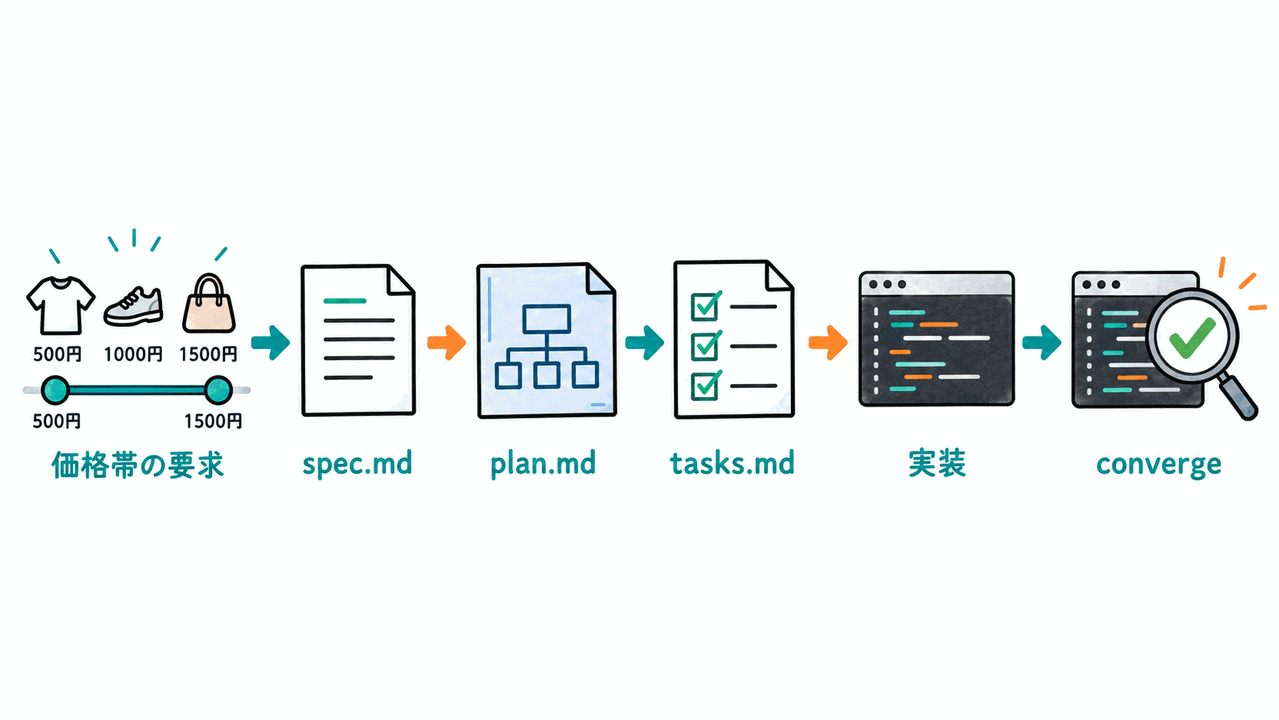
AIコーディングエージェントは、spec.mdを読んでplan.mdを作り、spec.mdの利用場面とplan.mdの技術設計からtasks.mdへ作業を分け、作業一覧に沿ってコードを変更します。
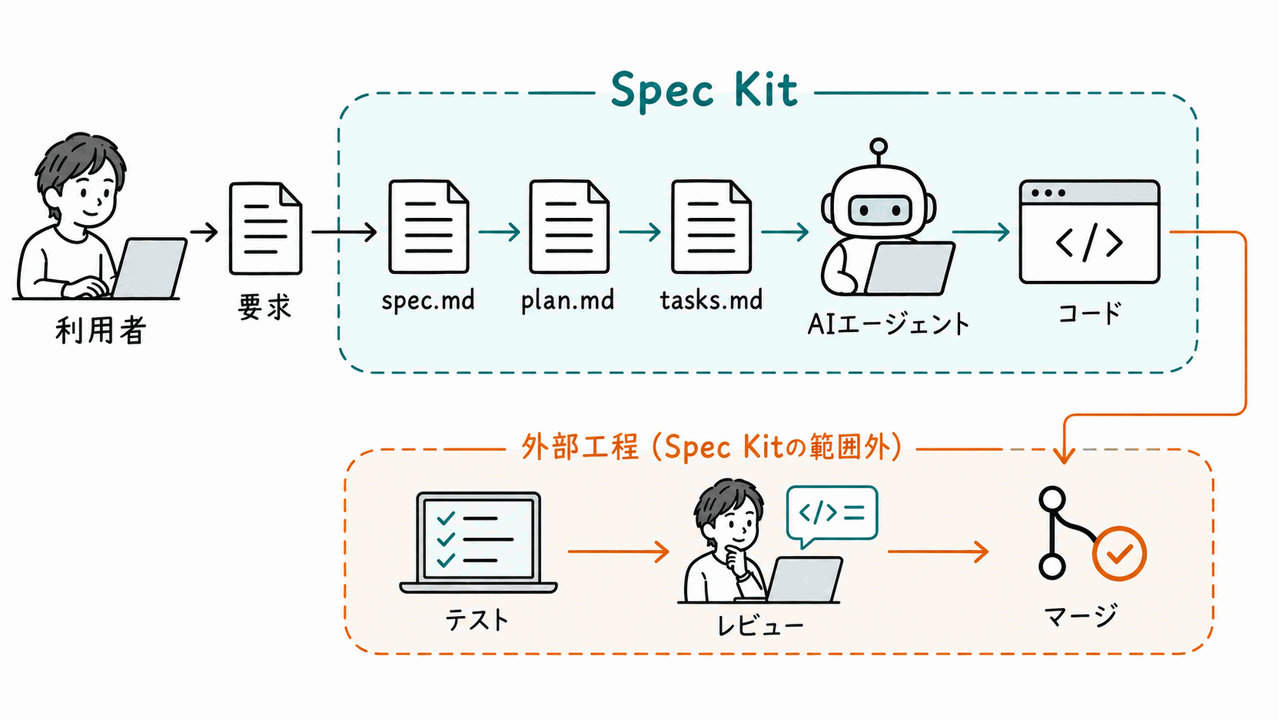
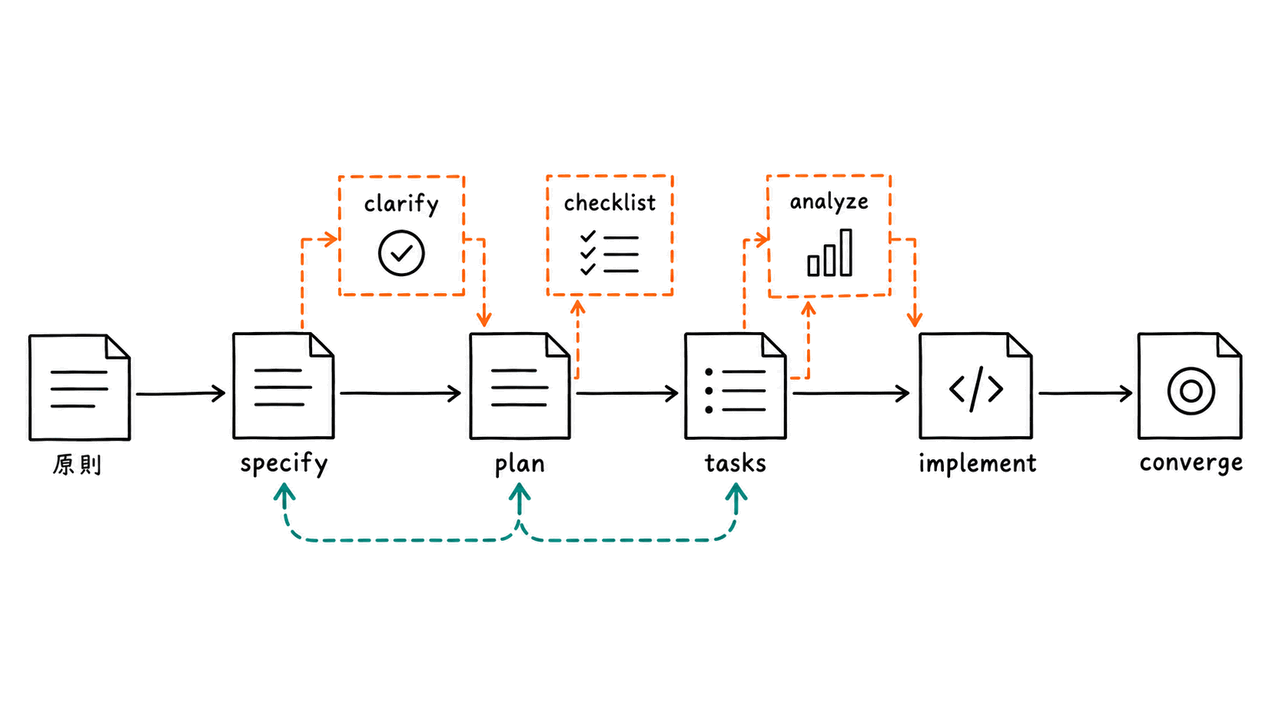
コアとなる仕様駆動開発(Spec-Driven Development、SDD)は、Specify → Plan → Tasks → Implement → Convergeの順に進みます。
バグ修正とアイデア評価には、コア工程から独立した入口があります。
機能開発を始める時はコアの仕様駆動開発を選び、既存の不具合を調べる時や実装前の案を評価する時は、それぞれの工程を選びます。
仕様駆動開発の担当範囲
仕様を作る段階では、利用者が何を達成したいかと、どの状態を成功とみなすかを決めます。 使用するフレームワーク、データベース、ファイル構成といった実装方法は、その後の技術計画で選びます。
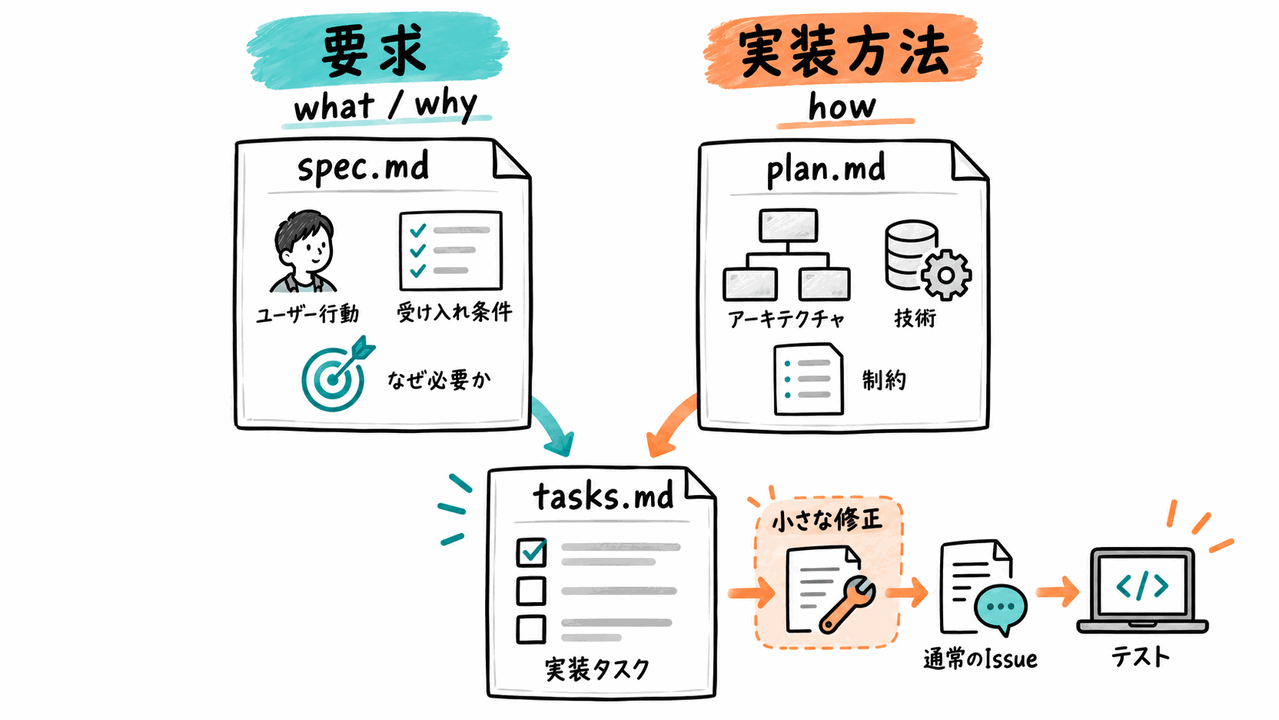
この順序により、利用者に見える動作を決めてから実装方法を選べます。 例えば「価格帯で商品を絞り込む」という要求に対し、最初からSQLの書き方を指定すると、境界値や不正入力の扱いが未確定のまま実装方法だけが固まります。 先に利用者から見える動作を決めれば、REST APIでもGraphQLでも同じ受入条件を使えます。
Spec Kitでは、変更の曖昧さと規模に応じて使う工程を選べます。 要求に複数の解釈がある機能では任意の品質ゲートを追加し、数行の明白な修正は通常のIssue、テスト、レビューで進めます。
AIエージェントとの接続
specifyCLIが担当するのは、プロジェクトの初期化と、選択したAIコーディングエージェントが読めるコマンドまたはスキル(再利用できる指示一式)の配置です。
初期化後は、AIコーディングエージェントの会話内で/speckit.specifyや/speckit.planを呼び出します。
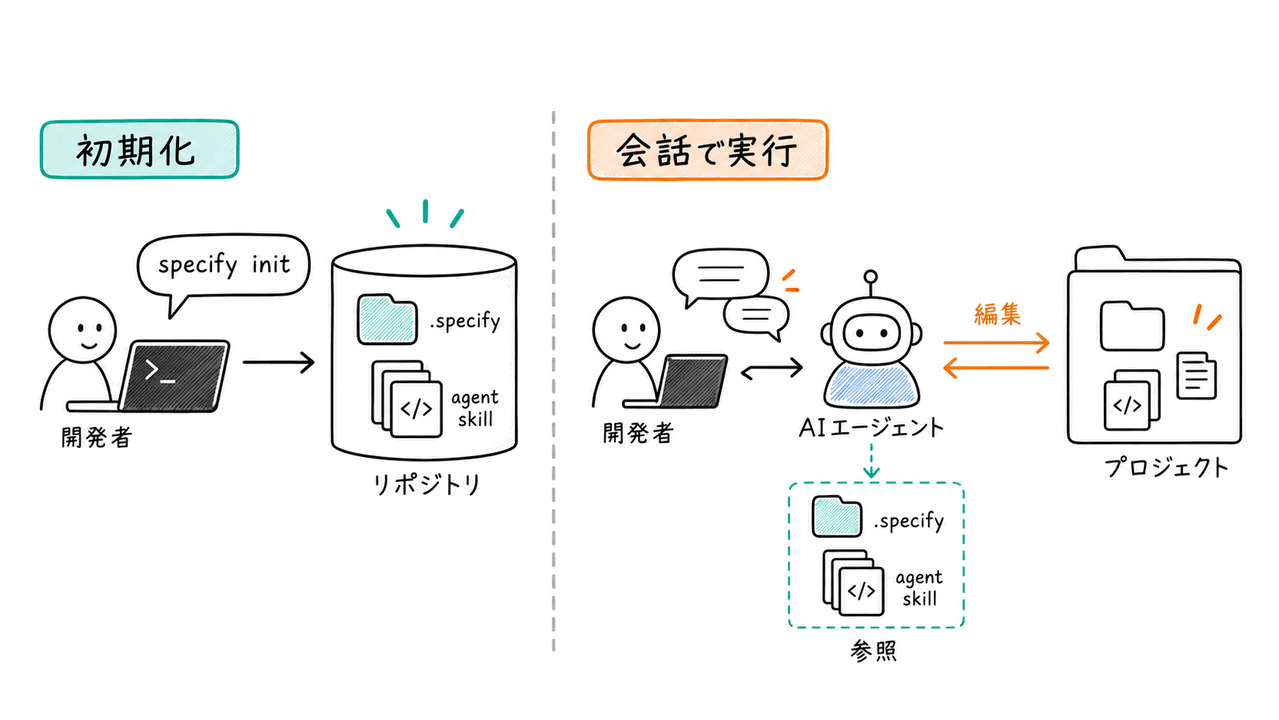
公式資料では操作名を/speckit.*で表しますが、表示形式は連携先によって変わります。
GitHub Copilotのスキル形式では/speckit-*、Codexでは$speckit-*として表示されます。
記号が異なっても、仕様、計画、作業一覧を順に扱う役割は同じです。
コード変更の隔離、ファイルの読取り、コードの編集、テストコマンドの実行権限、サンドボックスは、接続先のAIコーディングエージェントと開発環境が管理します。 Spec Kitは、その環境で使う工程と記録形式を提供します。
記録の構成
Spec Kitは、プロジェクト全体へ適用する原則と、機能ごとに作る仕様・計画・作業一覧を分けます。
plan.mdはspec.mdを入力にし、tasks.mdはspec.mdの利用場面とplan.mdの技術設計を入力にするため、要求からコードまでの判断をたどれます。
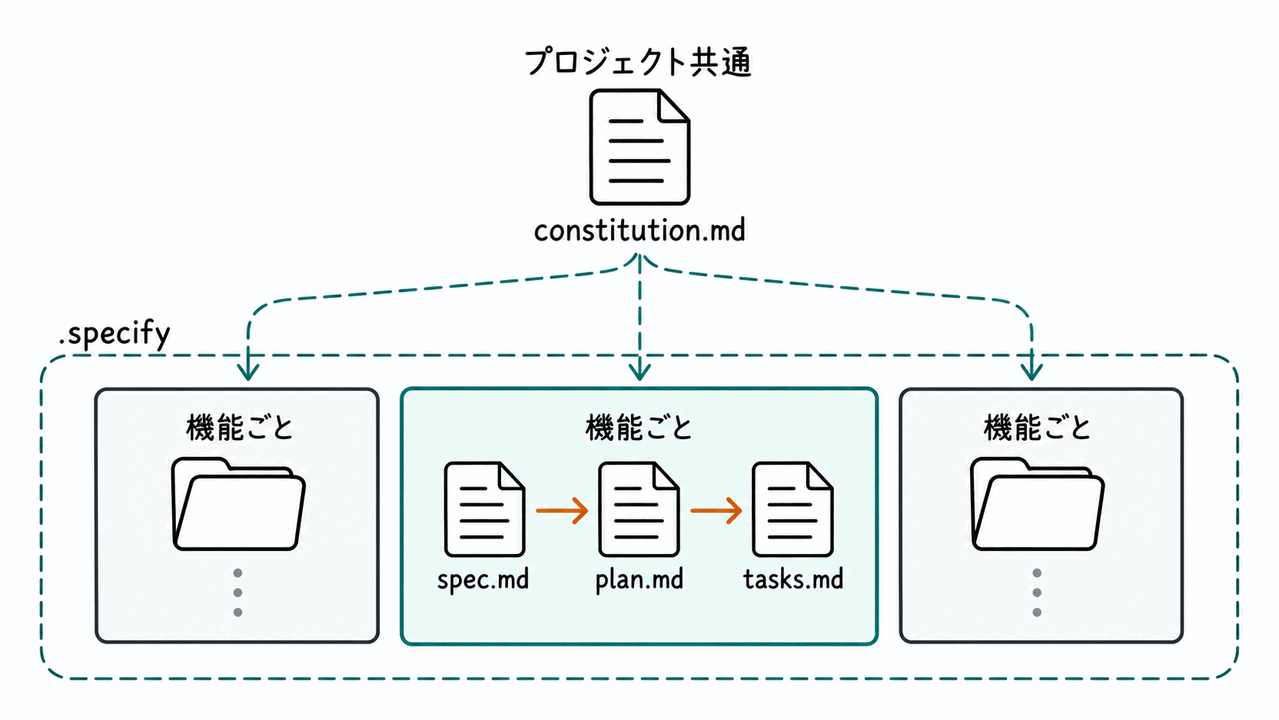
公式資料では、コマンド、テンプレート、スクリプトも含めてartifactという語を使います。
ここからは対象を明確にするため、constitution.md、spec.md、plan.md、tasks.mdを記録ファイルと呼びます。
初期化後のファイル構成
specify init --here --integration codex --script shを実行した場合、既存のソースコードとは別に、Spec Kitの共通基盤とCodex用のスキルが追加されます。
主要なファイルだけを抜き出すと、初期化直後の構成は以下のようになります。
project/
├── .specify/
│   ├── init-options.json
│   ├── integration.json
│   ├── integrations/
│   │   ├── speckit.manifest.json
│   │   └── codex.manifest.json
│   ├── memory/
│   │   └── constitution.md
│   ├── scripts/
│   │   └── bash/
│   └── templates/
│       ├── constitution-template.md
│       ├── spec-template.md
│       ├── plan-template.md
│       ├── tasks-template.md
│       └── checklist-template.md
└── .agents/
    └── skills/
        ├── speckit-specify/
        │   └── SKILL.md
        ├── speckit-plan/
        │   └── SKILL.md
└── ....specify/には、連携状態、プロジェクト原則、補助スクリプト、各記録のテンプレートが入ります。
一方、.agents/skills/はCodexがSpec Kitの操作を読み込む場所です。
GitHub Copilotでは.github/skills/を使うように、AI連携ファイルの保存先と形式は選んだ連携先によって変わります。
また、--script psまたは--script pyを選んだ場合は、補助スクリプトのディレクトリと形式も変わります。
この時点のconstitution.mdはプロジェクト原則を記入するための雛形です。
機能ごとのspec.md、plan.md、tasks.mdは、機能開発を始めた段階で作成されます。
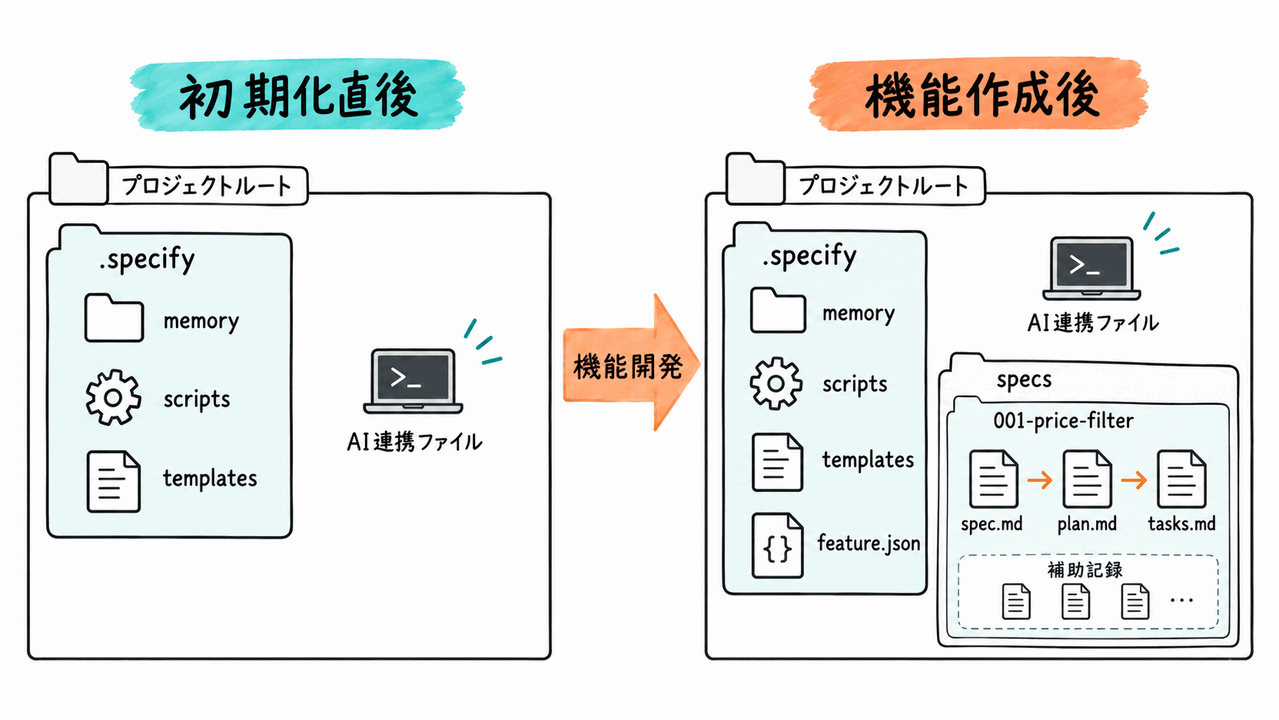
機能開発を始めると、共通基盤を残したまま、機能ごとのディレクトリがspecs/配下へ追加されます。
価格帯フィルターを最初の機能として作る場合、工程を進めた後の構成は以下のようになります。
project/
├── .specify/
│   └── feature.json
└── specs/
    └── 001-price-filter/
        ├── spec.md
        ├── checklists/
        │   ├── requirements.md
        │   └── api.md
        ├── plan.md
        ├── research.md
        ├── data-model.md
        ├── quickstart.md
        ├── contracts/
└── tasks.md/speckit.specifyは機能ディレクトリ、spec.md、組込みのchecklists/requirements.mdを作ります。
/speckit.clarifyは回答をspec.mdへ反映する際に、この組込みチェックリストも再評価します。
続く/speckit.planはplan.mdを中心に、調査結果、データモデル、動作確認手順、外部インターフェースの契約を必要な範囲で追加します。
最後に/speckit.tasksがtasks.mdを作り、技術計画を実行順の作業へ分けます。
一方、/speckit.checklistが作るのは、レビュー担当者が要求の完全性と明確さを確認するためのカスタムチェックリストです。
specs/<機能名>/checklists/<ドメイン>.mdへ保存され、対象ドメインのファイルがなければ新規作成し、すでにあれば項目を追記します。
組込みのrequirements.mdとは作成と更新の流れが異なります。
.specify/feature.jsonは現在操作する機能ディレクトリを指します。
そのため、.specify/をSpec Kitの共通基盤、specs/<機能名>/を各機能の開発記録として分けて読むと、ファイルの役割を追いやすくなります。
プロジェクト原則
全機能で守る判断基準は.specify/memory/constitution.mdへ保存します。
/speckit.constitutionを実行すると、入力検証、互換性、テスト方針、アーキテクチャの境界をプロジェクト原則として作成または更新できます。
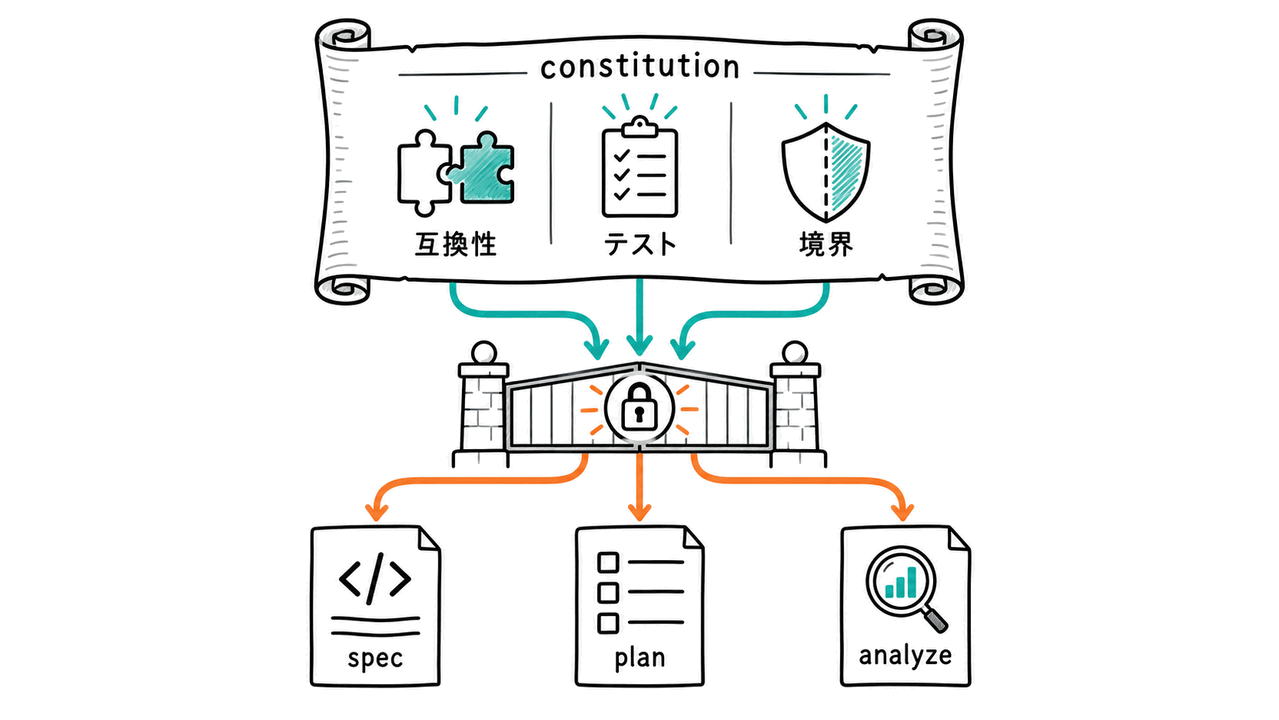
既存プロジェクトでconstitutionを作る時は、現在のREADME、設計判断、CI設定、コントリビューションガイドから、実際に守っている規則を確認します。 例えば、公開APIの互換性を維持しているなら、その条件を原則へ書きます。 データベース移行にロールバック手順を求めているなら、後続の計画が確認できる形で残します。
実態と異なる原則を書くと、後続の計画や分析は守れない条件を繰り返し指摘します。 constitutionには、機能を設計する時に実際に使う判断基準を書きます。
機能ごとの記録
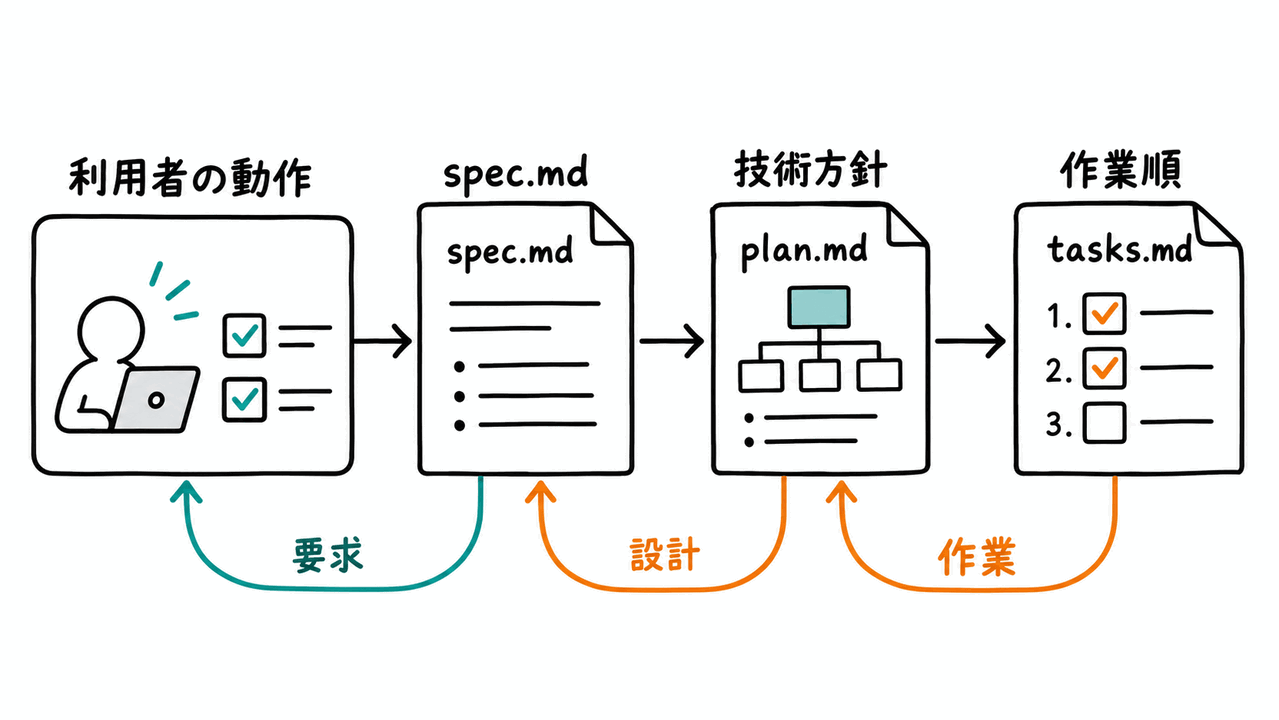
機能ごとの中心はspec.md、plan.md、tasks.mdです。
3つのファイルは役割が異なり、変更理由に応じた戻り先を作ります。
| ファイル | 保存する内容 | 修正する場面 |
|---|---|---|
spec.md |
利用者に見える動作、利用場面、受入条件 | 要求や期待する動作が変わった時 |
plan.md |
技術構成、既存設計との接続、制約、実現方法 | アーキテクチャや実装方針が変わった時 |
tasks.md |
依存順に並べたテストと実装作業 | 作業の不足や順序の問題が見つかった時 |
例えば、「最低価格と最高価格は片方だけでも指定できる」は利用者に見える動作なのでspec.mdへ置きます。
「クエリ文字列を整数へ変換して検索条件ビルダーへ渡す」は実現方法なのでplan.mdへ置きます。
「上限だけを指定するAPIテストを追加する」は実行する作業なのでtasks.mdへ置きます。
役割を分けておけば、要求を変えずに実装方法だけを見直せます。
反対に、要求が変わった時はコードだけを直さず、spec.mdから後続ファイルへの影響を確認できます。
作業対象の選択
Spec Kitが参照する作業対象は、.specify/feature.jsonに記録された機能ディレクトリです。
SPECIFY_FEATURE_DIRECTORY環境変数を使えば、別のディレクトリを明示することもできます。
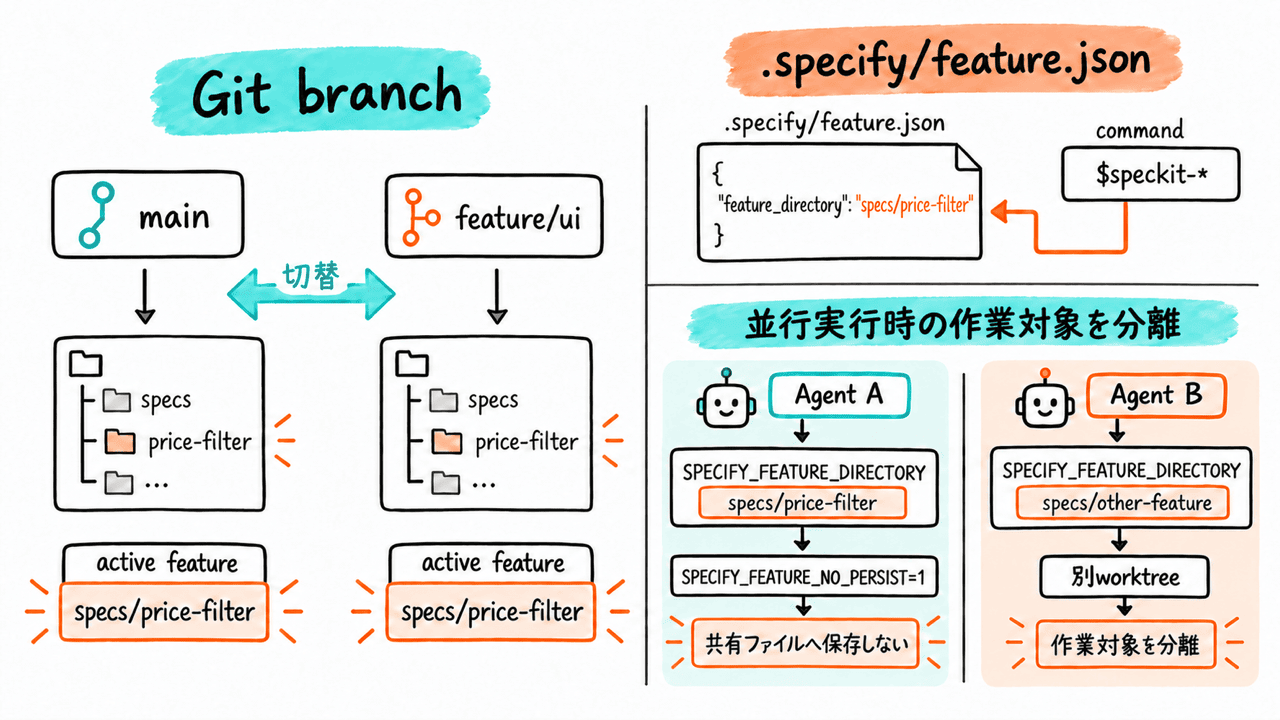
この違いは、複数機能を並行して扱う時に重要です。
Spec Kitが参照する作業対象は、Gitブランチを切り替えた後も.specify/feature.jsonが指すディレクトリに残ります。
別の機能へ移る時は、ブランチと.specify/feature.jsonが指すディレクトリを一緒に確認します。
同じチェックアウトで複数のAIコーディングエージェントが別の機能を処理する場合は、共有される.specify/feature.jsonへの書込みも分けます。
各エージェントへSPECIFY_FEATURE_DIRECTORYを設定しただけでは、コマンドが選択結果を共有ファイルへ保存し、別のエージェントが参照する機能を上書きする可能性があります。
SPECIFY_FEATURE_NO_PERSIST=1を併用して共有ファイルへの保存を止めるか、機能ごとに別のworktreeを使って作業対象の状態を分離します。
コア工程は、Gitリポジトリがない環境でも利用できます。 機能ブランチを使う運用は、任意のGit拡張機能で追加できます。
基本フロー
コア工程と任意の品質ゲートは、以下の順で進めます。 各段階では操作を実行した事実だけでなく、更新されたファイルと次へ進む条件を確認します。
-
プロジェクト原則を決める
/speckit.constitutionを実行し、.specify/memory/constitution.mdへ互換性、テスト、アーキテクチャの原則を保存する。 後続の計画で判断に使える具体性があるかを確認する。 -
要求を仕様へ変える
/speckit.specifyへ利用者の目的と期待する動作を渡す。 作業対象のspec.mdに利用場面と検証可能な受入条件が作られ、組込みのchecklists/requirements.mdが要求品質を評価していることを確認する。 -
曖昧な要求を解消する
解釈が分かれる場合は、
/speckit.clarifyで確認する範囲を指定する。 回答がspec.mdへ反映され、組込みの要求チェックリストが再評価され、技術設計を始める前に動作の分岐が解消されたことを確認する。 -
技術計画を作る
/speckit.planへ使用する技術、既存アーキテクチャ、互換性を含む制約を渡す。plan.mdと補助記録から、受入条件をどの構成で実現するか追えることを確認する。 -
要求品質を確認して作業へ分ける
要求の完全性を人が確認する場合は、
/speckit.checklistでレビュー担当者が所有するカスタムチェックリストを作る。 チェック済みの印が要求品質の確認を示していることを確かめた後、/speckit.tasksを実行し、tasks.mdへ作業を依存順に並べる。 -
記録間の矛盾を調べる
/speckit.analyzeを実行し、spec.md、plan.md、tasks.mdの矛盾や欠落を調べる。 要求の問題はspec.md、設計の問題はplan.md、作業分解の問題はtasks.mdへ戻して直す。 -
実装して不足を戻す
/speckit.implementでtasks.mdを依存順に実行し、完了後に/speckit.convergeを実行する。 不足がtasks.mdへ追加されたら、追加分を実装して再びconvergeを実行する。 -
プロジェクト固有の完了条件を確認する
Spec Kitの外側で、プロジェクトのテスト、静的検査、コードレビュー、マージ条件を確認する。
Convergedは記録とコードの対応を示すため、プロジェクト固有の完了条件はこの段階で個別に確認する。
要求から作業一覧まで
/speckit.specifyへ渡す要求では、利用者に見える動作と理由を中心にします。
フレームワーク名やデータベース設計は/speckit.planで決めます。
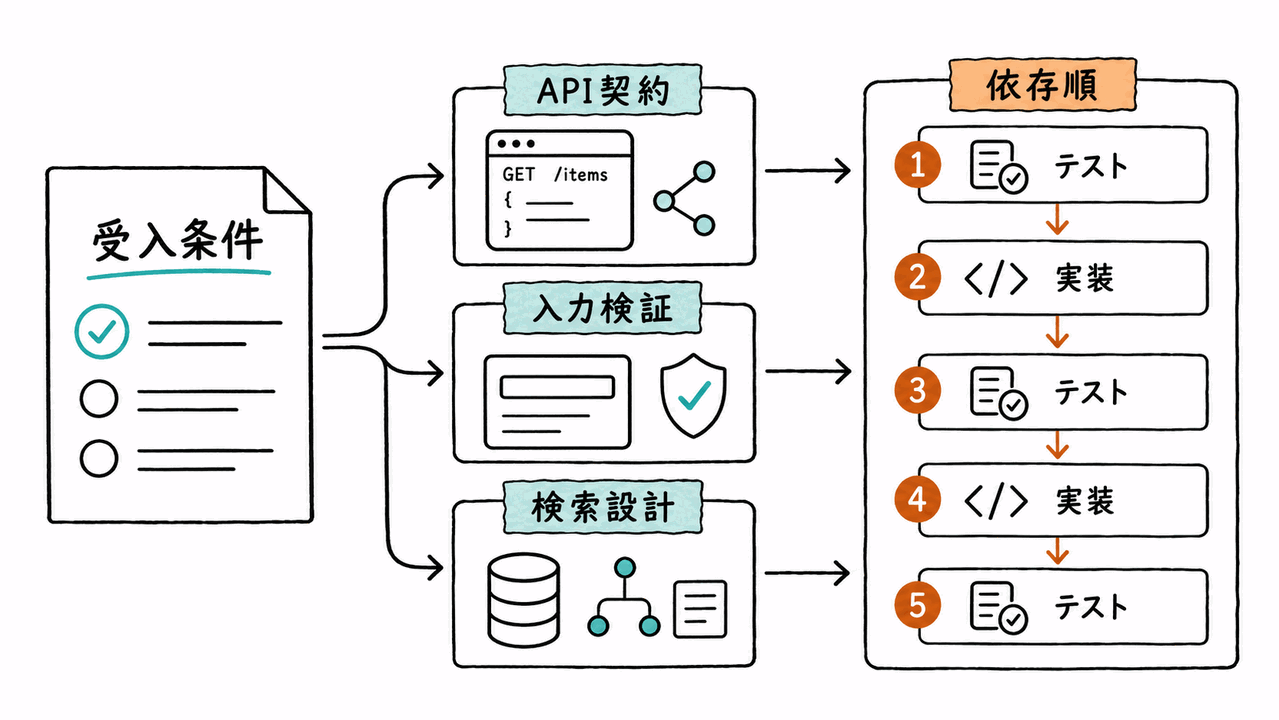
/speckit.tasksは、設計内容を準備、共通の前提、利用者の目的ごとの実装、横断的な仕上げへ分けます。
テストが要求されている場合は、独立したテスト工程へまとめず、対応する利用者の目的の中に配置します。
並行できる作業には目印が付くため、依存する作業を先に実行しつつ、独立した変更を分担できます。
タスクを細かく分ける目的は、各受入条件を実現する設計と、その設計を検証するテスト・実装作業を追える状態にすることです。
実装と収束確認
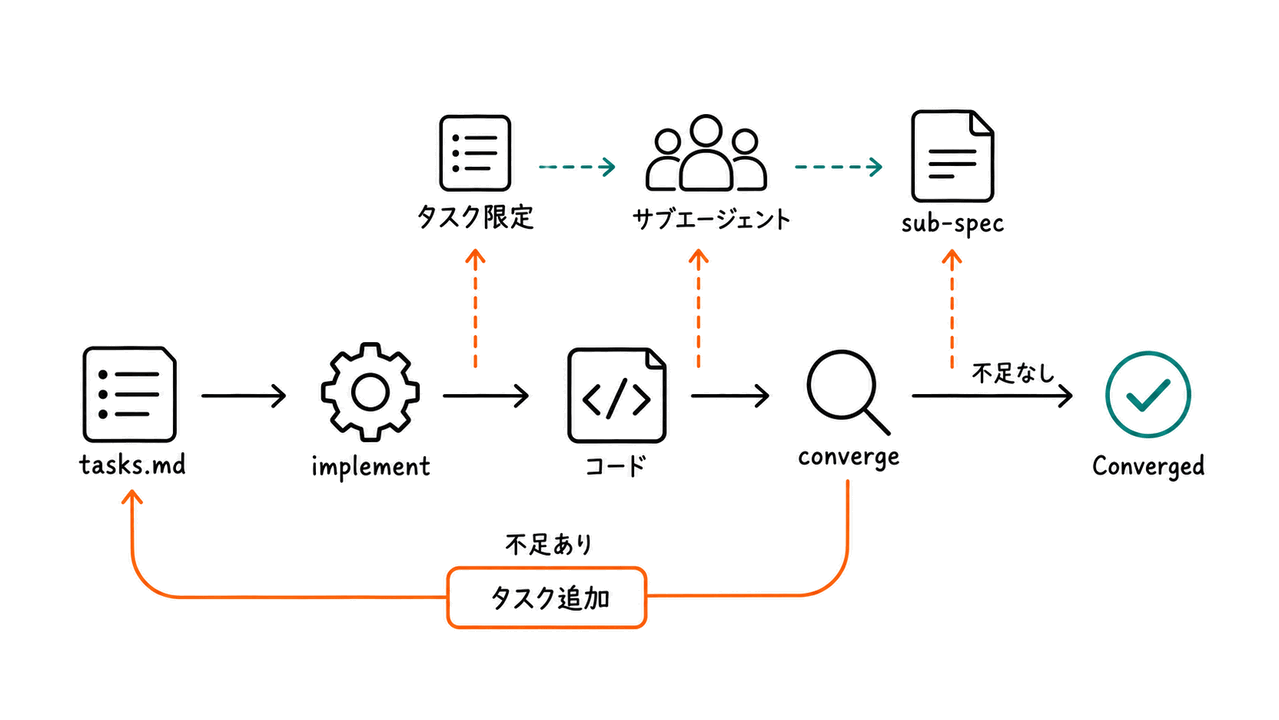
/speckit.implementはtasks.mdを依存順に実行します。
大きな機能を1回で処理するとAIエージェントのコンテキストが不足するため、公式資料は段階的な分割方法を示しています。
まず、1回で実行するタスク番号またはフェーズを限定します。 対応するAIエージェントで並行タスクを処理したい場合は、タスクごとにサブエージェントへ委譲できます。 両方を組み合わせても1つのフェーズがコンテキストに収まらない場合に限り、機能を独立した小さな仕様へ分けます。
この分割方法は、公式資料でspec of specs(仕様を束ねる仕様)と呼ばれています。
最初にロードマップを作り、独立してテストできる機能へ分けてから、依存順と範囲を記録します。
各機能は個別のspec.md、plan.md、tasks.mdを持つため、分割には記録と調整の負担が増えます。
そのため、タスク数の限定、サブエージェントへの委譲、両方の併用でも収まらない場合の選択肢です。
実装後の/speckit.convergeは、コードをspec.md、plan.md、tasks.mdと照合します。
不足が見つかると、tasks.mdのConvergenceセクションへ新しいタスクを追記します。
追加されたタスクをimplementで処理し、再びconvergeを実行します。
不足が見つからない時はtasks.mdを変更せず、Convergedと報告します。
価格帯フィルターの実例
ここからは、既存の商品検索APIへmin_priceとmax_priceを追加する変更を追います。
既存のcategoryによる絞り込みと認可動作を維持し、境界値と不正な範囲も扱います。
受入条件を決める
最初に、利用者に見える動作だけを/speckit.specifyへ渡します。
例えば、入力は以下のようにします。
/speckit.specify
既存の商品検索APIへ、任意のmin_priceとmax_priceを追加する。
片方だけでも指定でき、両方を指定した時は境界値を含める。
既存の`category`フィルターと認可動作は変えない。
不正な価格範囲には400を返す。この入力は、利用者に見える動作と互換性を指定しています。
データベースと実装言語は/speckit.planで決めます。
spec.mdには、API利用者が確認できる動作を利用場面と受入条件として残します。
以下は、説明に必要な部分へ絞ったspec.mdの例です。
 ## User Story 1 - Filter products by price

As an API client, I can narrow product results by a minimum price,
a maximum price, or both without changing existing category filtering.

 ### Acceptance Scenarios

1. Given products priced 500, 1000, and 1500,
   when min_price=1000 and max_price=1500,
   then products priced 1000 and 1500 are returned.
2. When only min_price is specified, no upper bound is applied.
3. When only max_price is specified, no lower bound is applied.
4. When min_price is greater than max_price, the API returns 400.
5. When both values are absent, the existing response is unchanged.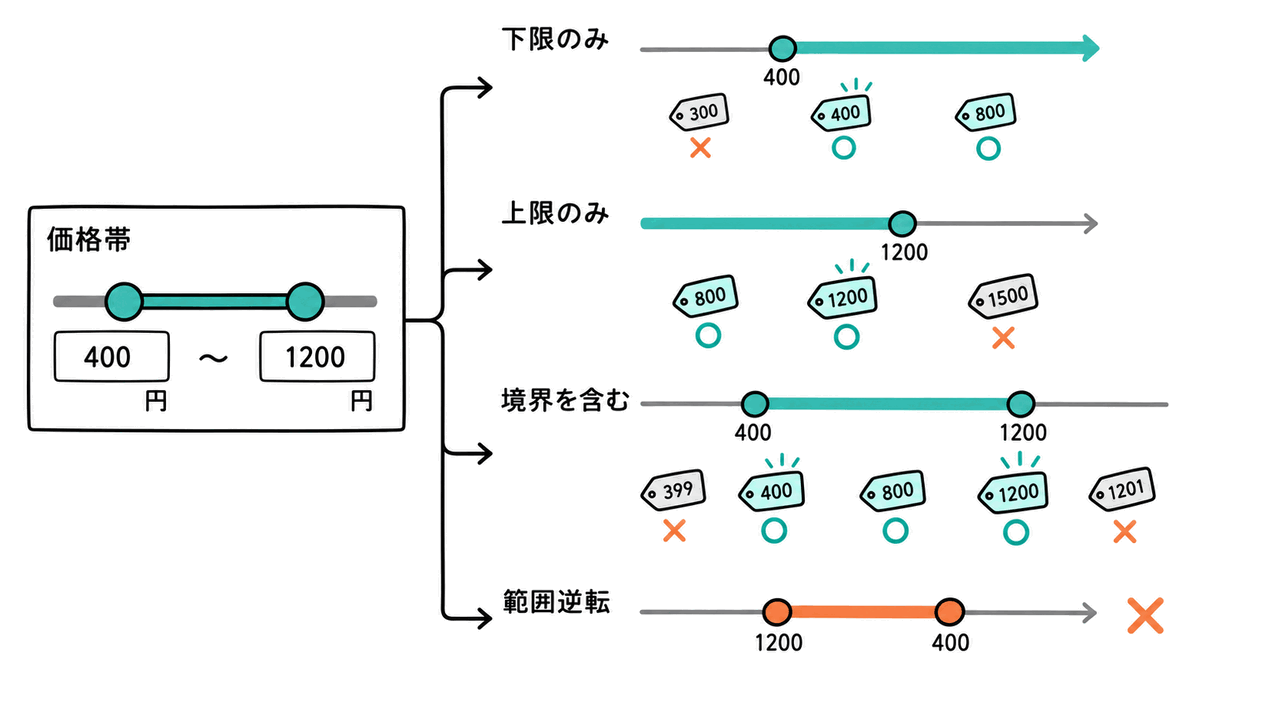
この例で確認する値は、片方だけの指定、両方の指定、範囲の逆転、未指定時の互換性です。
min_price=1000とmax_price=1500の例では、1000と1500を結果へ含めるため、境界値を含む条件も検証できます。
それでも、価格の単位、負数、小数、同額の範囲は決まっていません。
/speckit.clarifyで「価格値の形式と境界条件へ集中する」と指定し、設計へ進む前に回答をspec.mdへ反映します。
例えば価格を0以上の整数、同額の下限と上限を有効な1点範囲と決めれば、実装者とテスト担当者が同じ条件を参照できます。
技術方針を分ける
受入条件が決まったら、/speckit.planで既存プロジェクトに合わせた実現方法を選びます。
入力には、既存の技術構成と変更時の制約を渡します。
/speckit.plan
既存のTypeScript REST APIとPostgreSQLを使う。
クエリパラメータの検証は既存のリクエストスキーマへ追加する。
検索条件ビルダーを拡張し、既存の`category`条件と組み合わせる。
公開レスポンスのスキーマと認可ミドルウェアは変更しない。
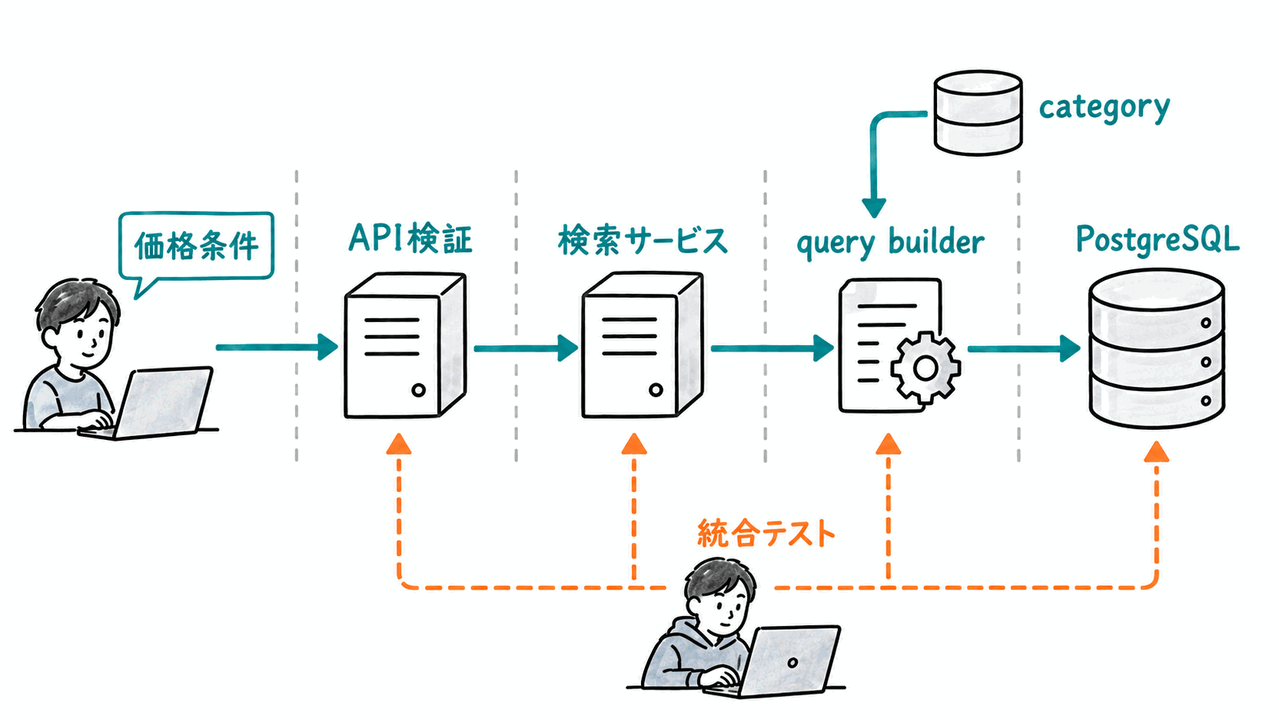
既存プロジェクトのTDD方針に従い、受入条件ごとのAPIテストを実装より先に追加する。この計画では、受入条件をAPIの入力検証、アプリケーションサービス、クエリビルダー、統合テストへ割り当てます。 要求側へPostgreSQLやTypeScriptを混ぜていないため、利用者に見える動作を保ったまま実装方法を見直せます。
計画の要点は、以下のようにplan.mdへ残せます。
 ## Technical Context

- Language: TypeScript
- API: Existing REST endpoint `GET /products`
- Storage: PostgreSQL through the existing query builder
- Compatibility: Keep response schema, authorization, and category filtering

 ## Design

1. Parse optional `min_price` and `max_price` as non-negative integers.
2. Reject the request when both exist and `min_price > max_price`.
3. Add inclusive `>=` and `<=` predicates to the existing query builder.
4. Cover single-bound, two-bound, invalid-range, and compatibility cases.1番目と2番目はAPI境界で入力を検証する方針です。 3番目は境界値を含む受入条件を検索処理へ対応させています。 4番目は、追加機能だけでなく既存の検索条件と認可を壊していないか確認する範囲です。
作業と確認結果を結ぶ
この例では利用者がTDDで進めるよう明示したため、/speckit.tasksはAPIテストを実装より先に置きます。
以下は今回の変更に必要な部分へ絞った例です。
 ## User Story 1 - Filter products by price

- [ ] T001 [US1] Add failing min-only and max-only tests in tests/api/products.test.ts
- [ ] T002 [US1] Add boundary and invalid-range tests in tests/api/products.test.ts
- [ ] T003 [US1] Extend the request schema in src/api/product-search-request.ts
- [ ] T004 [US1] Add inclusive predicates in src/search/product-query-builder.ts
- [ ] T005 [US1] Verify category filtering and authorization in tests/api/products.test.tsT001とT002で受入条件を失敗するテストへ変えた後、T003とT004で入力検証と検索処理を実装します。
最後のT005は、価格帯フィルターを追加しても既存の条件と認可が変わらないことを確認します。
この順序なら、新しい実装がテストより先に正解を決める状態を避けられます。
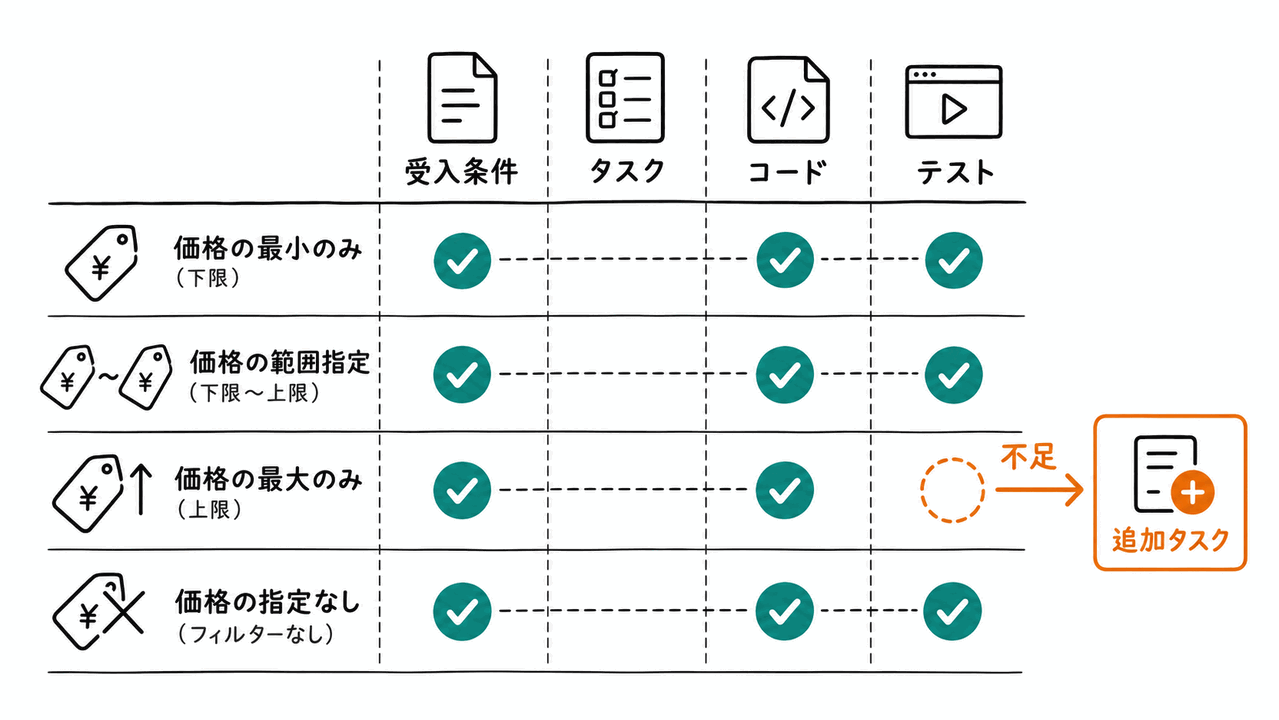
実装前に/speckit.analyzeを実行し、受入条件に対応しないタスクや、タスク化されていない計画項目を探します。
例えば、max_priceだけを指定する受入条件があるのにT001が下限のテストしか含まない場合は、tasks.mdを直してから実装します。
/speckit.implement後の/speckit.convergeでも、同じ不足が見つかることがあります。
その場合は、上限だけを指定するテストをConvergenceタスクとして追加し、実装とテストを終えてから再実行します。
最終的に受入条件からコードとテスト結果までを対応付け、追加タスクなしでConvergedになれば、Spec Kit上の収束確認は完了です。
既存プロジェクトで使う
既存プロジェクトでは、次に行う限定した変更からSpec Kitを使います。 変更前の状態を通常の差分で確認できるようにしてから、既存の規則をconstitutionへ反映します。
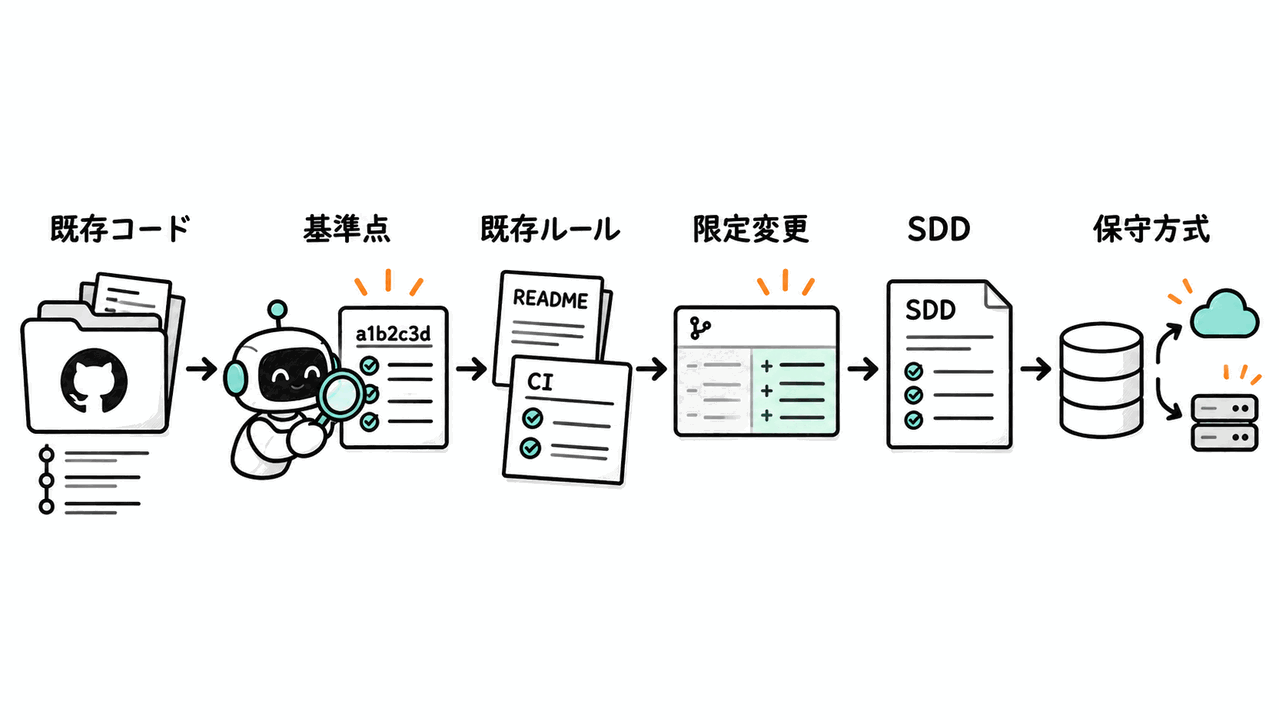
完了後には、機能ごとの記録を履歴として固定するのか、現在の契約として更新し続けるのかを決めます。 保守方法は、チームの運用規則として選びます。
小さな変更から始める
既存リポジトリでspecify init --here --forceを使う前に、未コミットの変更を整理し、生成されるファイルをレビューできる基準点を作ります。
--forceは空でないディレクトリへの初期化を許可するため、差分を戻せる状態で実行します。
初期化後のconstitutionには、すでに守っている条件を書きます。 公開APIの互換性、既存サービスの境界、マイグレーションのロールバック、テストコマンドが候補です。 存在しない標準を埋めると、後続工程が実装と合わない制約を参照します。
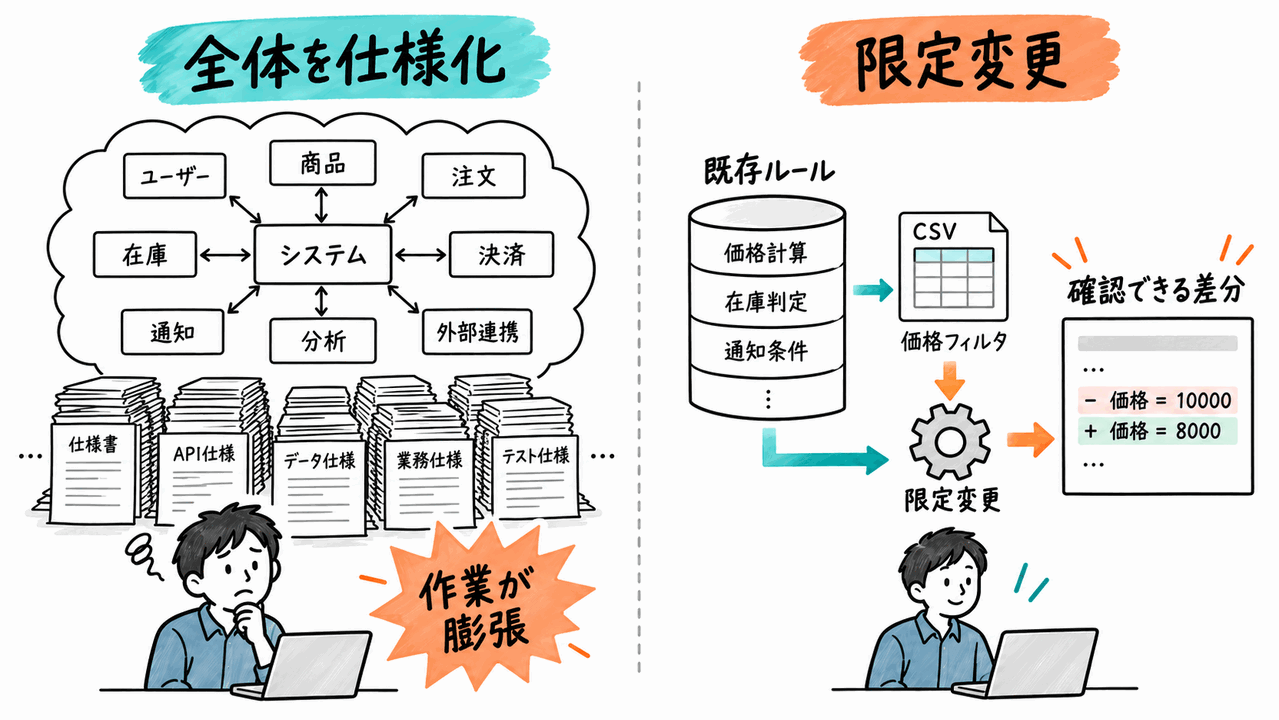
最初の対象は、独立してレビューできる変更へ絞ります。
商品検索APIの価格帯フィルターなら、既存コードは現在の設計を知るための材料として読み、spec.mdには今回追加する動作と維持する互換性だけを書きます。
開始条件は、今回追加する動作と維持する互換性を仕様へ書くことです。
完了後の仕様を残す
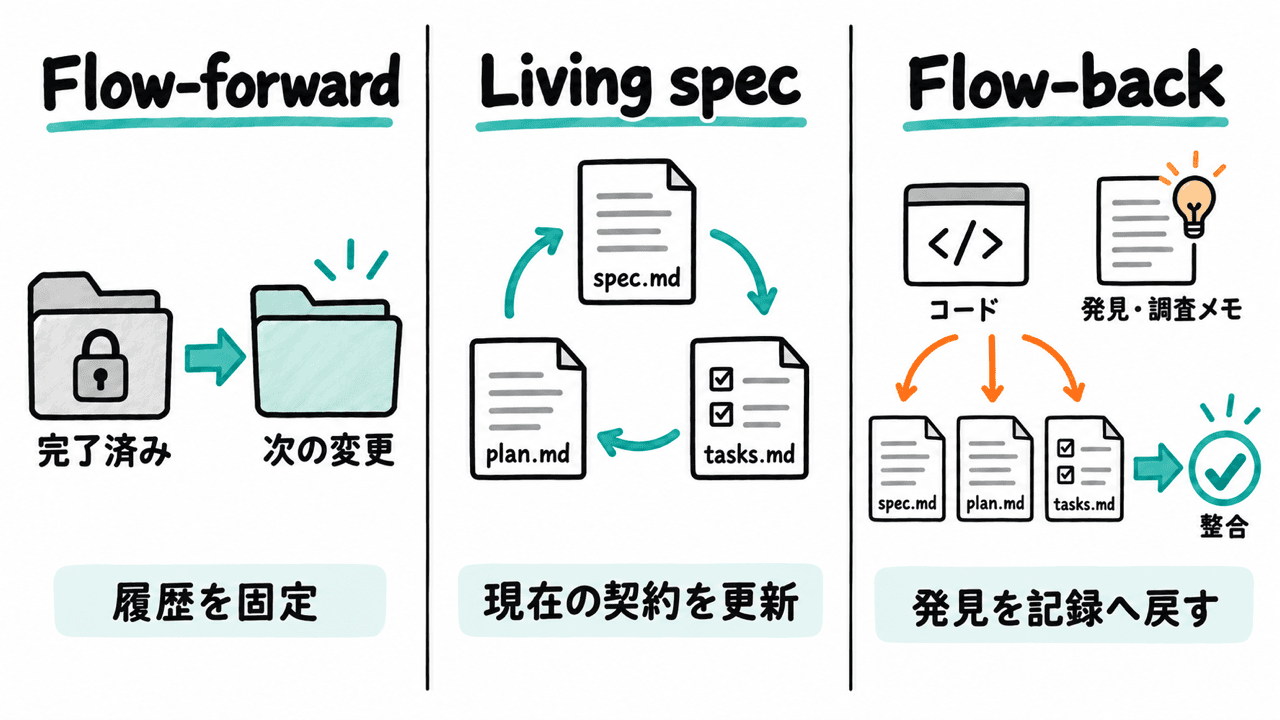
要求が変わった時にspec.md、plan.md、tasks.mdをどう扱うかは、3つの方式から選べます。
採用する方式は、チーム内で共有する運用規則として決めます。
| 方式 | 更新方法 | 向く場面 | 注意点 |
|---|---|---|---|
| Flow-forward | 完了済みディレクトリを固定し、変更ごとに新しい機能記録を作る | 監査履歴と変更順を残したい | 関連判断が複数のディレクトリへ分散する |
| Living spec | spec.mdを先に更新し、plan.mdとtasks.mdを再生成または修正する |
仕様を現在の契約として保つ | 再生成時に実装理由を失う可能性がある |
| Flow-back | 実装中の発見から任意の記録を直し、最後に一式を整合させる | 小規模チームで速く反復する | 反映漏れによる記録間のずれが起きやすい |
Flow-forwardを選ぶ場合、価格帯フィルターの追加後に価格通貨を増やす変更があれば、新しい機能ディレクトリを作ります。 過去のディレクトリは、その時点の判断を示す履歴として残します。
Living specでは、通貨対応を現在のspec.mdへ先に反映し、計画と作業一覧を更新します。
どの方式でも、完了済みディレクトリを編集できる領域と考えるのか、履歴として固定するのかをconstitutionまたはチーム規則へ書きます。
規則がなければ、後続の担当者は古いspec.mdと現在のコードのどちらを信頼するか判断できません。
品質ゲートと完了の境界
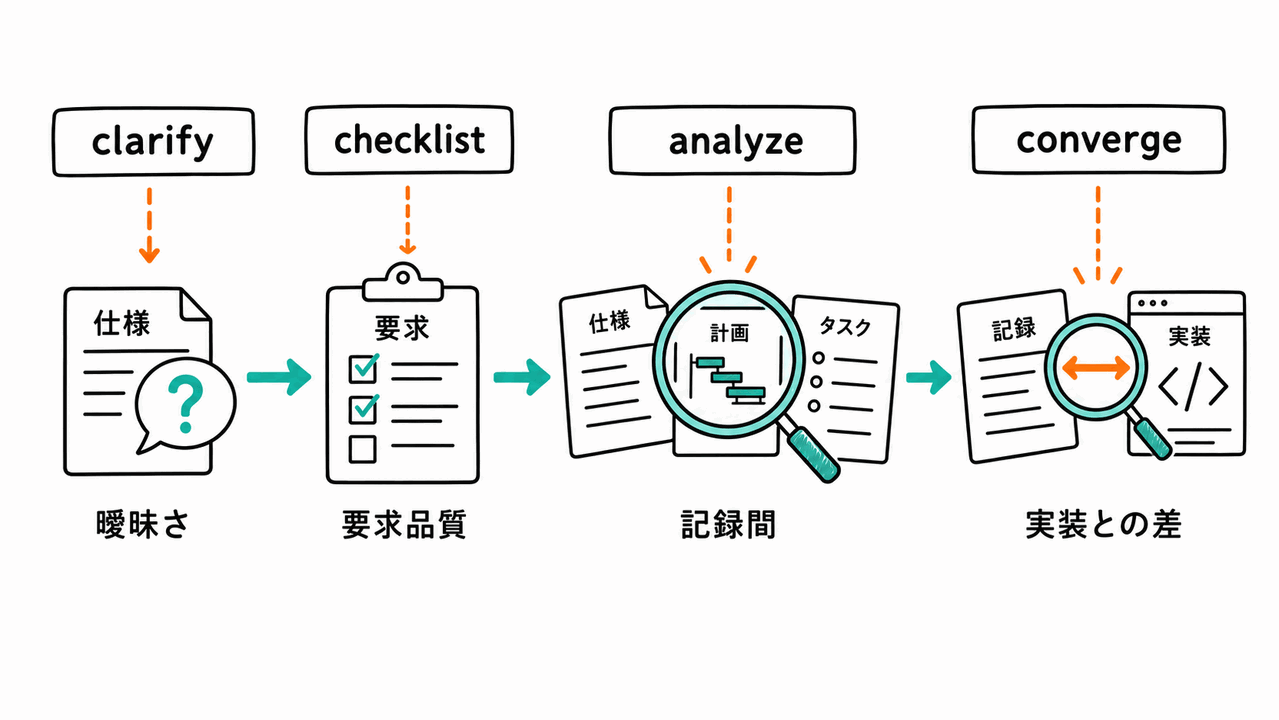
Spec Kitの品質確認は、要求の曖昧さ、要求そのものの品質、記録間の整合性、実装との不足を別々に調べます。 全てを1つの合格印として扱うと、何を確認できたのか分からなくなります。
実装前の確認
/speckit.clarifyは、spec.mdの曖昧な箇所について1回に最大5問を提示し、回答を同じ仕様へ反映します。
技術計画を作る前に、利用者へ確認しなければ決まらない動作を解消する操作です。
/speckit.specifyが作るchecklists/requirements.mdは、機能仕様に付属する組込みの要求チェックリストです。
/speckit.clarifyは仕様の回答を反映した後、このチェックリストも再評価します。
/speckit.checklistは、要求が完全で明確かをレビュー担当者が確認するためのカスタムチェックリストを別に作ります。
カスタムチェックリストはchecklists/<ドメイン>.mdへ保存され、同じドメインで再実行すると既存項目を残して新しい項目を追記します。
カスタムチェックリストの確認済みの印は要求品質の確認を示し、実装やテストの完了は表しません。
/speckit.implementはchecklists/内の全ファイルについて総項目数、確認済み項目数、未確認項目数を集計します。
未確認項目が1つでもあれば実装を止めて続行するかを尋ねますが、組込み・カスタムのどちらにも印を付けません。
/speckit.analyzeは、spec.md、plan.md、tasks.mdを変更せずに読み、矛盾と欠落を報告します。
要求の不足はspec.md、技術方針の矛盾はplan.md、作業漏れはtasks.mdへ戻して修正します。
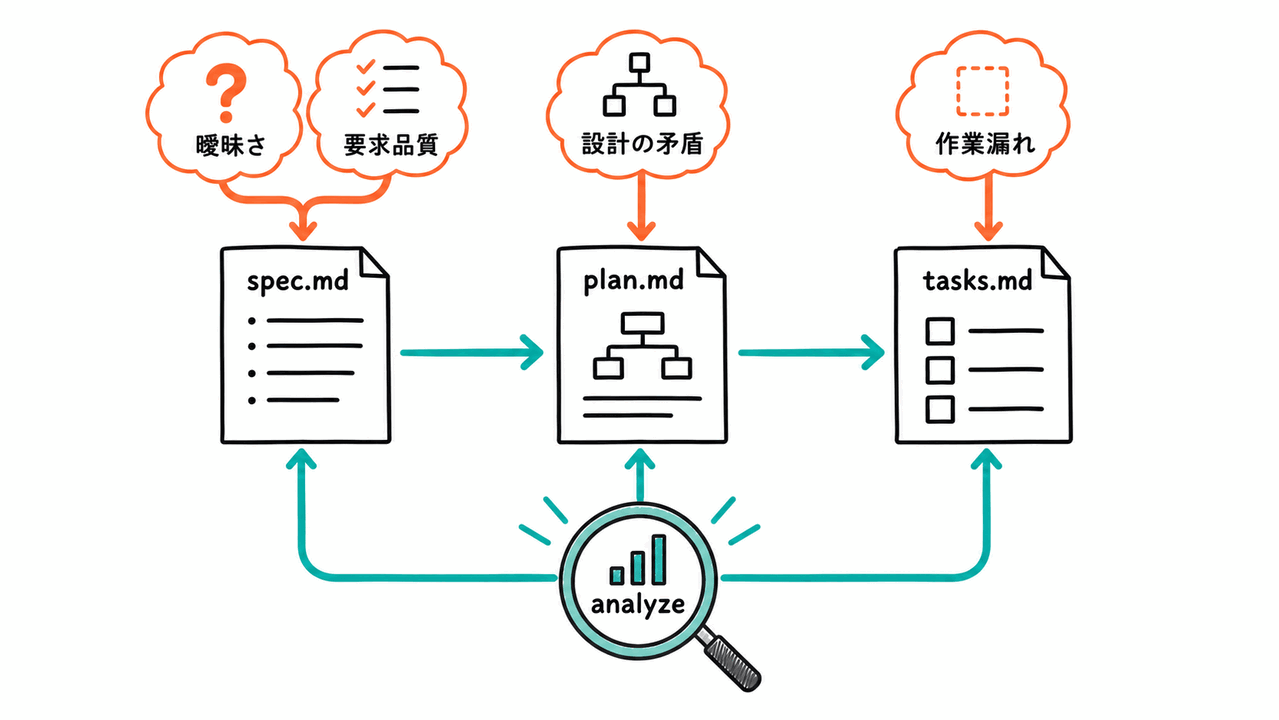
この分離により、要求不足をタスク追加だけで隠さずに済みます。 原因を持つファイルから直した後、影響を受ける後続工程を再実行します。
Convergedの意味
/speckit.convergeがConvergedと報告するのは、現在のspec.md、plan.md、tasks.mdに対してコードの不足が見つからなかった時です。
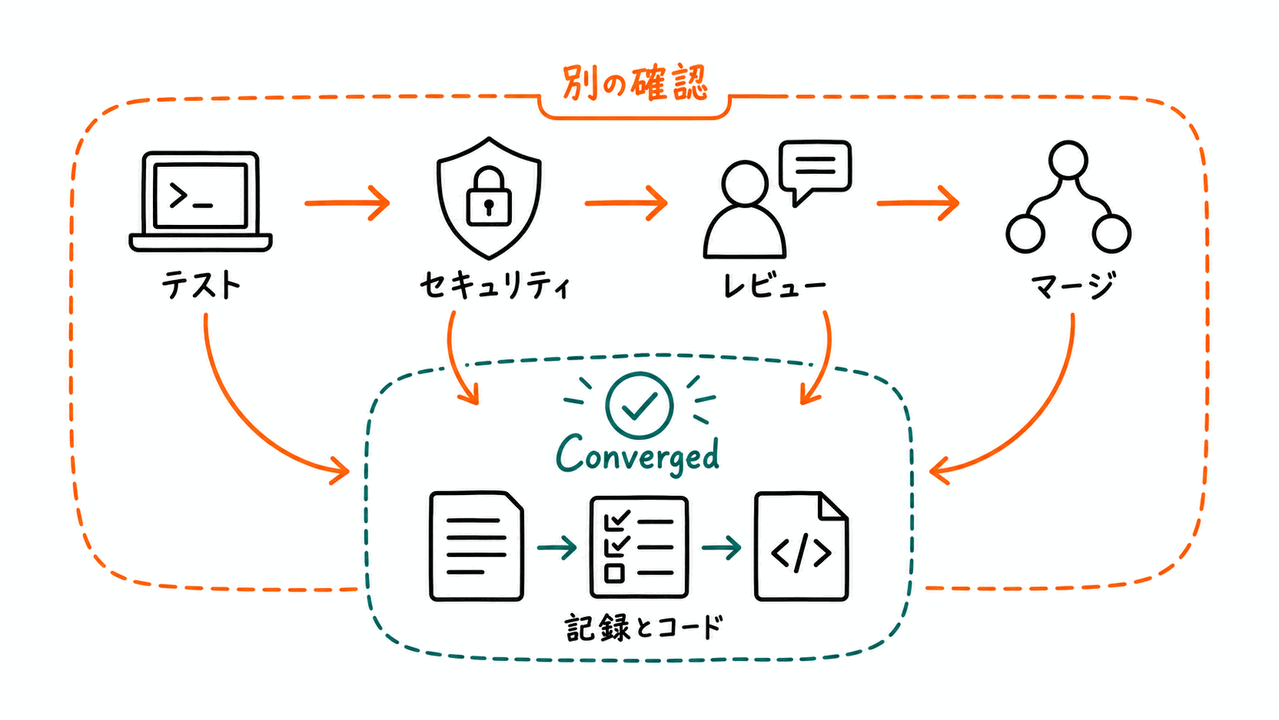
ソフトウェア全体の完成には、仕様そのものが利用者の課題を正しく表しているか、テストが必要な不具合を検出できるか、セキュリティ上の問題がないか、メンテナーがマージを許可したかを別に確認します。 Spec Kitの公式リポジトリでも、エージェントによるconvergenceと決定的な検査を分けています。 テスト、静的検査、CodeQL、メンテナーのレビュー、リリース判断が後者に当たります。
したがって、完了条件を以下のように分けます。
| 確認 | 判定する内容 |
|---|---|
組込みのrequirements.md |
機能仕様の要求品質を再評価したか |
/speckit.checklist |
レビュー担当者が要求の完全性と明確さを確認したか |
analyze |
仕様、計画、作業一覧が矛盾していないか |
converge |
記録に対して実装の不足がないか |
| テストとCI | 実行した検査が期待する結果を返すか |
| コードレビュー | 差分の設計、保守性、安全性を承認できるか |
| マージ条件 | リポジトリが要求する全条件を満たしたか |
1つが合格しても、別の行まで自動で合格にはなりません。 変更後にコードや仕様を直した場合は、影響を受ける確認をもう1度実行します。
向く条件と注意点
Spec Kitは、要求、技術計画、作業分解を別々にレビューし、複数の人やAIコーディングエージェントが同じ記録を引き継ぐ開発に向きます。 機能数の多さより、実装前に分けたい判断と、実装後に戻したい不足があるかで採用範囲を決めます。
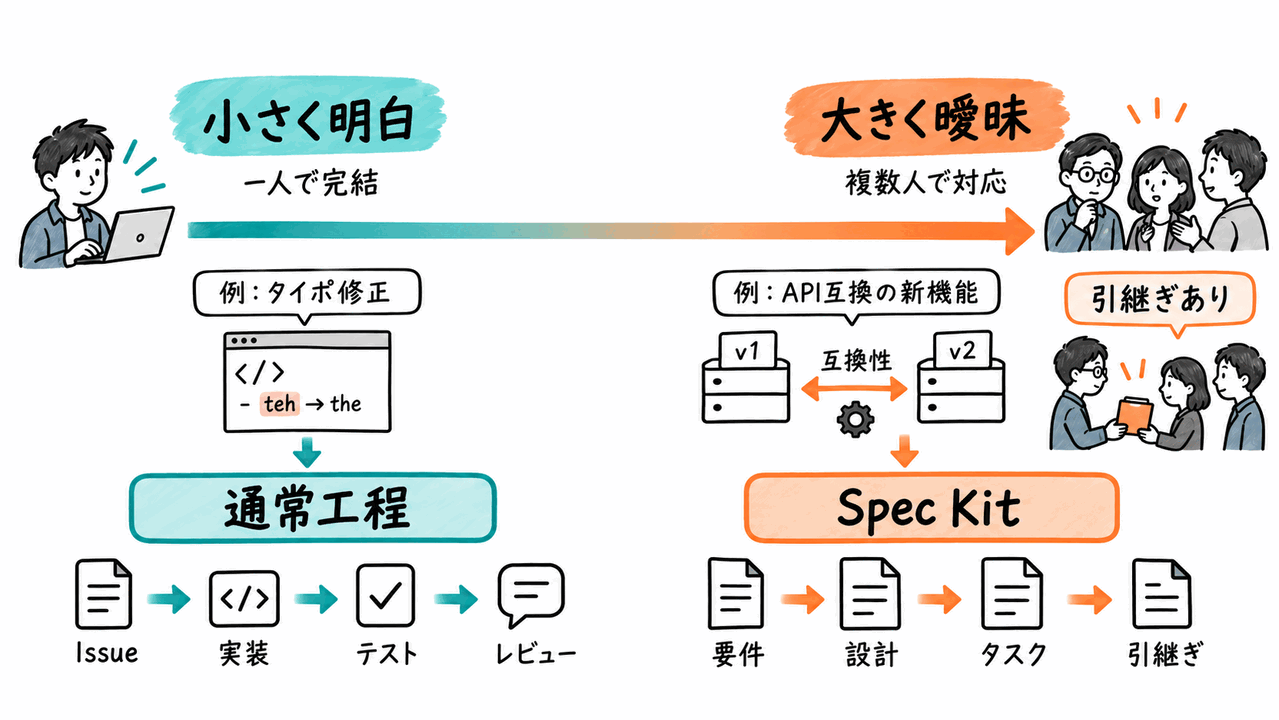
採用判断
受入条件に複数の解釈がある場合や、公開APIの互換性を守る場合は、段階別の記録が判断の支えになります。 複数フェーズへの分割やAIエージェントの交代でも、同じ記録を引き継げます。 任意の品質ゲートは、残っている不確実性へ合わせて選びます。
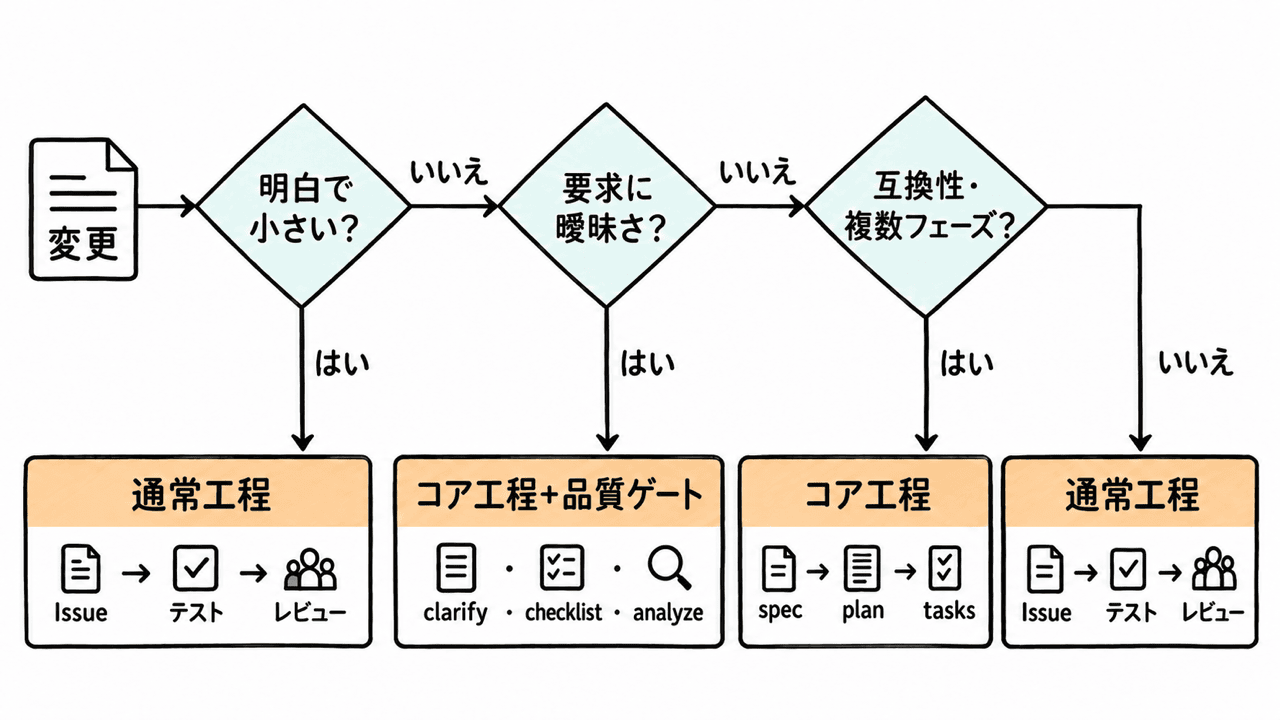
誤字修正や数行の明白な不具合修正まで毎回spec.md、plan.md、tasks.mdへ分けると、記録をレビューする時間が変更自体を上回ります。
変更理由と完了条件を通常のIssue、再現テスト、コードレビューで追える小さな修正は、通常工程で進めます。
導入前には、誰が各記録を確認し、完了後にどの方式で保守するかも決めます。 ファイルだけを生成しても、古くなった記録を直す担当がいなければ、後続のAIエージェントへ誤った前提を渡します。
版と生成ファイルの更新
この記事は、2026年10月13日に公開されたGitHub Spec Kit v1.2.0と、2026年10月16日時点の公式資料を基準にしています。 Spec Kitを更新する時は、CLI本体とリポジトリ内へ配置されたファイルを別々に確認します。
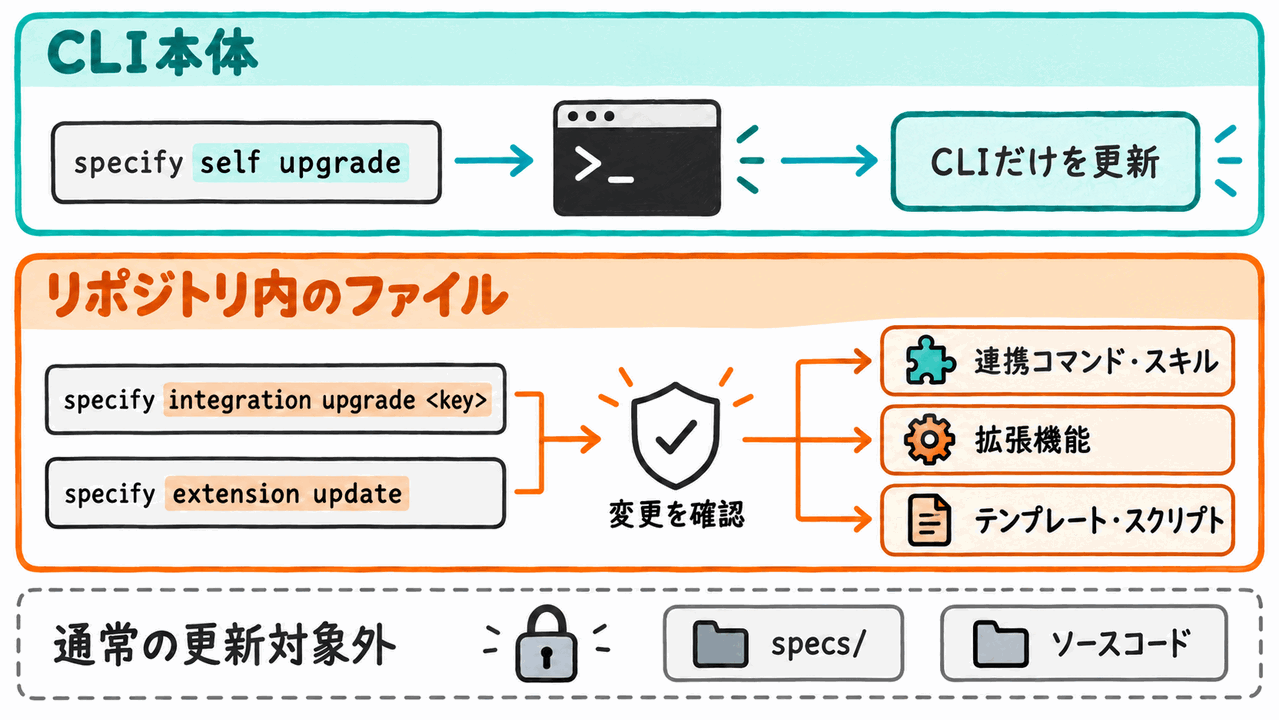
specify self upgradeはCLI本体を更新します。
一方、選択した連携先のコマンドまたはスキルはspecify integration upgrade <key>、拡張機能はspecify extension updateで更新します。
CLI本体とリポジトリ内のコマンド、テンプレート、スクリプトは、それぞれ更新します。
連携設定の更新はマニフェストを使い、管理対象ファイルのローカル変更を検出します。
変更済みのファイルがある時は処理を止めるため、--forceで上書きする前に差分を確認します。
通常の連携設定更新は、specs/配下の仕様、計画、作業一覧とソースコードを更新対象から除外します。
最後に
GitHub Spec Kitの中心は、プロジェクト原則、機能要求、技術計画、作業一覧を別々の記録へ置き、問題が見つかった時に原因を持つファイルへ戻れる工程です。
商品検索APIの例では、境界値や不正入力をspec.mdで決め、既存アーキテクチャへの接続をplan.mdへ置き、テストと実装をtasks.mdへ分けました。
実装後はconvergeで記録との不足を調べますが、テスト、コードレビュー、マージ判断は別に残ります。
既存プロジェクトでは、限定した変更から使います。 完了後の記録を履歴として固定するか、現在の契約として更新するかはチームで決めます。
GitHub Spec Kitの公式資料では、コアSDD、既存プロジェクトへの導入、完了後の仕様保守、最新版の更新方法を確認できます。
他でも色々記事を書いているのでぜひよろしければ読んでいってください!